
Qwen3.8-27B peut tourner en agent de codage local avec Ollama et OpenCode, sans monter une infra compliquée. Le vrai sujet, c’est votre machine, le bon lancement du modèle, puis le test dans un projet Python simple.
Votre machine peut elle suivre ?
Votre machine peut suivre si elle dispose idéalement d’au moins 24 Go de VRAM GPU, ou d’assez de RAM système pour accepter un déchargement partiel du modèle, avec des performances moins confortables.
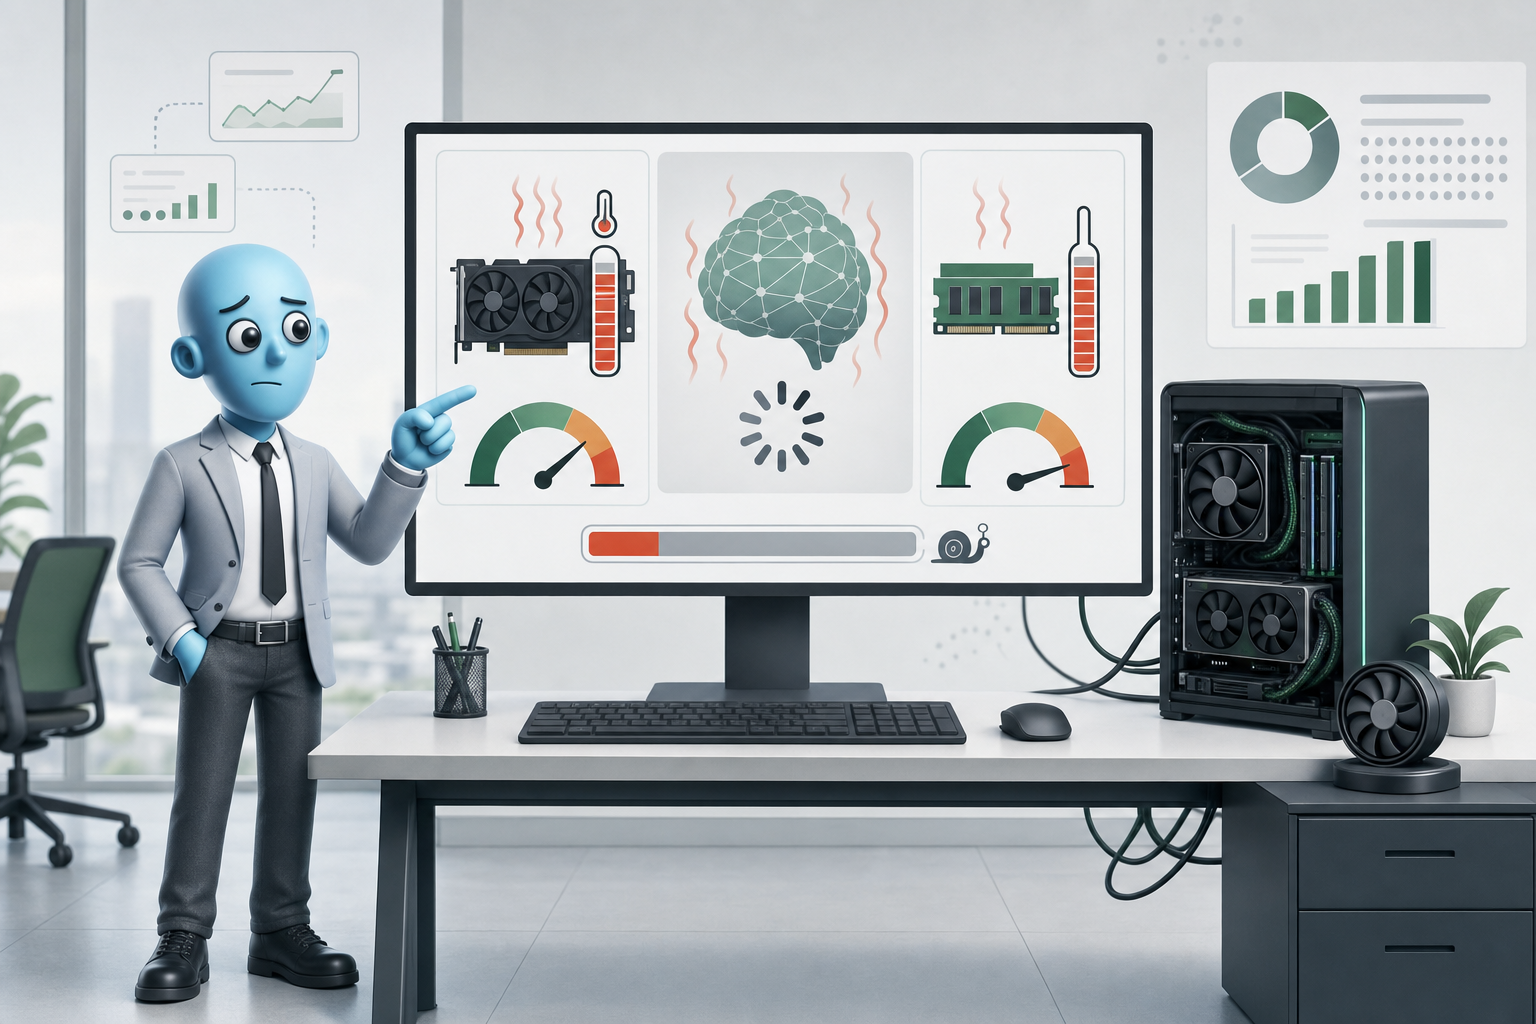
Un modèle comme Qwen3.8-27B demande beaucoup de mémoire parce qu’il faut charger ses poids quelque part. Les poids, c’est en gros tout ce que le modèle a appris pendant son entraînement. Quand ils sont en VRAM, donc dans la mémoire de la carte graphique, le GPU y accède vite et l’inférence répond correctement. L’inférence, c’est juste le moment où le modèle génère sa réponse.
Si la VRAM manque, Ollama peut décharger une partie du modèle en RAM système. Ça permet parfois de lancer le modèle quand même, mais il ne faut pas se mentir, ça ralentit souvent les réponses. Sur un agent de code, ça se ressent vite. Vous demandez une modification, il réfléchit, il relit des fichiers, il génère du code… Si chaque étape prend trop longtemps, l’expérience devient pénible.
Je vérifie toujours ce point avant l’installation chez un client. Très souvent, le problème ne vient pas d’Ollama, ni d’OpenCode, ni même du modèle. La machine est juste trop courte. Et là, on peut perdre une heure à chercher un bug qui n’existe pas.
Je lance ces commandes pour avoir une lecture rapide de la machine avant d’aller plus loin :
- Linux avec GPU NVIDIA
nvidia-smi- Linux mémoire système
free -h- MacOS mémoire système
sysctl hw.memsize- Windows PowerShell mémoire système
Get-CimInstance Win32_ComputerSystem | Select-Object TotalPhysicalMemory| Situation | Ce que ça veut dire | Conseil |
| Configuration confortable | Vous avez au moins 24 Go de VRAM GPU disponible. | Vous pouvez tester Qwen3.8-27B dans de bonnes conditions. |
| Configuration possible mais lente | Vous avez moins de VRAM, mais beaucoup de RAM système. | Vous pouvez tenter avec déchargement en RAM, mais attendez-vous à des réponses plus lentes. |
| Configuration à éviter | Vous avez peu de VRAM et peu de RAM système. | Choisissez un modèle plus petit, sinon l’agent risque d’être inutilisable. |
Comment installer Ollama proprement ?
J’installe Ollama avec le script officiel quand je suis sur Linux, puis je vérifie que la commande répond avant de télécharger le modèle.
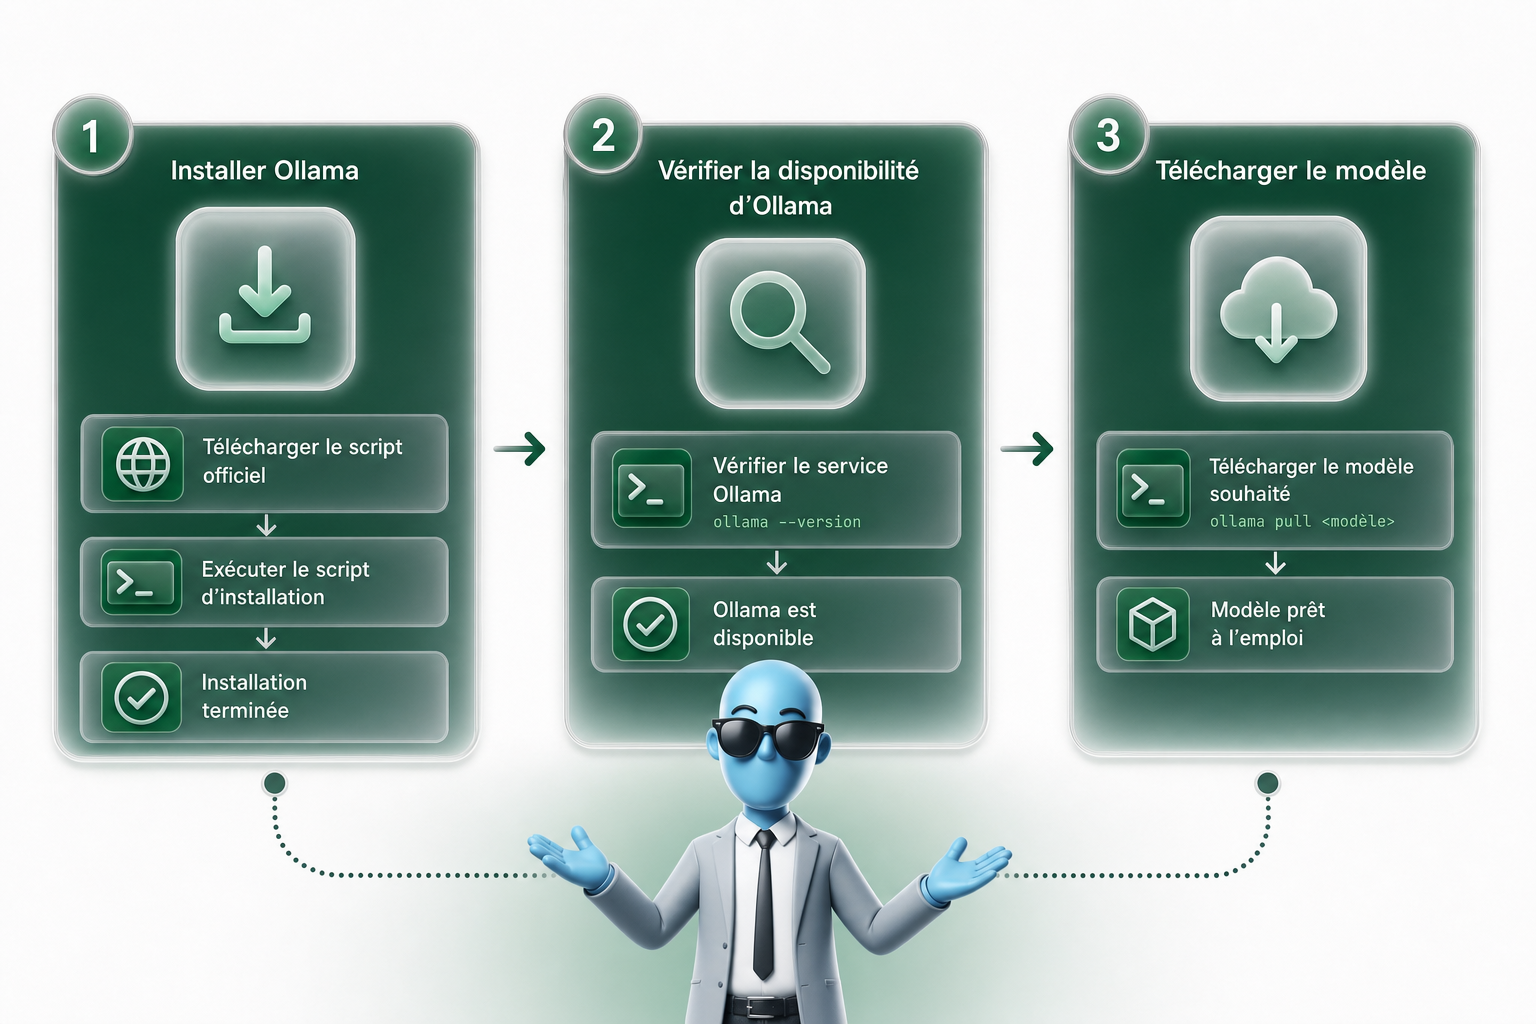
Dans ce flux, Ollama fait le gros du travail pénible. Il installe le runtime, lance le modèle, le garde accessible localement, et expose une API sur votre machine. Dit simplement, c’est lui qui évite de configurer à la main toute la couche d’exécution du modèle. C’est beaucoup plus simple qu’une installation plus manuelle avec llama.cpp, où il faut souvent gérer la compilation, les paramètres d’exécution, les chemins de modèles, les options GPU… Ça se fait, bien sûr. Mais pour lancer vite un agent de code local, je préfère partir propre et simple.
Sur Linux, j’utilise cette commande. Elle télécharge le script officiel d’Ollama et lance l’installation directement depuis le terminal.
curl -fsSL https://ollama.com/install.sh | shUne fois l’installation terminée, je vérifie tout de suite que la commande est disponible. Ça évite de découvrir un problème plus tard, au moment où on veut récupérer Qwen ou brancher l’agent de code.
ollama --versionSi Ollama répond avec un numéro de version, c’est bon. On peut continuer. Si la commande n’est pas reconnue, je ne vais pas plus loin. Je rouvre d’abord le terminal, parce que le chemin de la commande peut ne pas avoir été rechargé. Si ça ne suffit pas, je vérifie que l’installation s’est bien terminée avant de télécharger le modèle.
Sur macOS ou Windows, vous pouvez aussi passer par l’installeur officiel d’Ollama si c’est plus confortable. Ça marche très bien aussi. Mais pour ce tuto, je reste centré sur le terminal, parce que c’est plus simple à reproduire et ça évite les ambiguïtés. Chez un client, c’est souvent comme ça que je standardise l’installation : une commande, une vérification, puis seulement après on attaque les modèles.
Comment charger Qwen3.8-27B ?
Je démarre le serveur Ollama puis je télécharge Qwen3.8-27B avant de l’appeler depuis OpenCode.
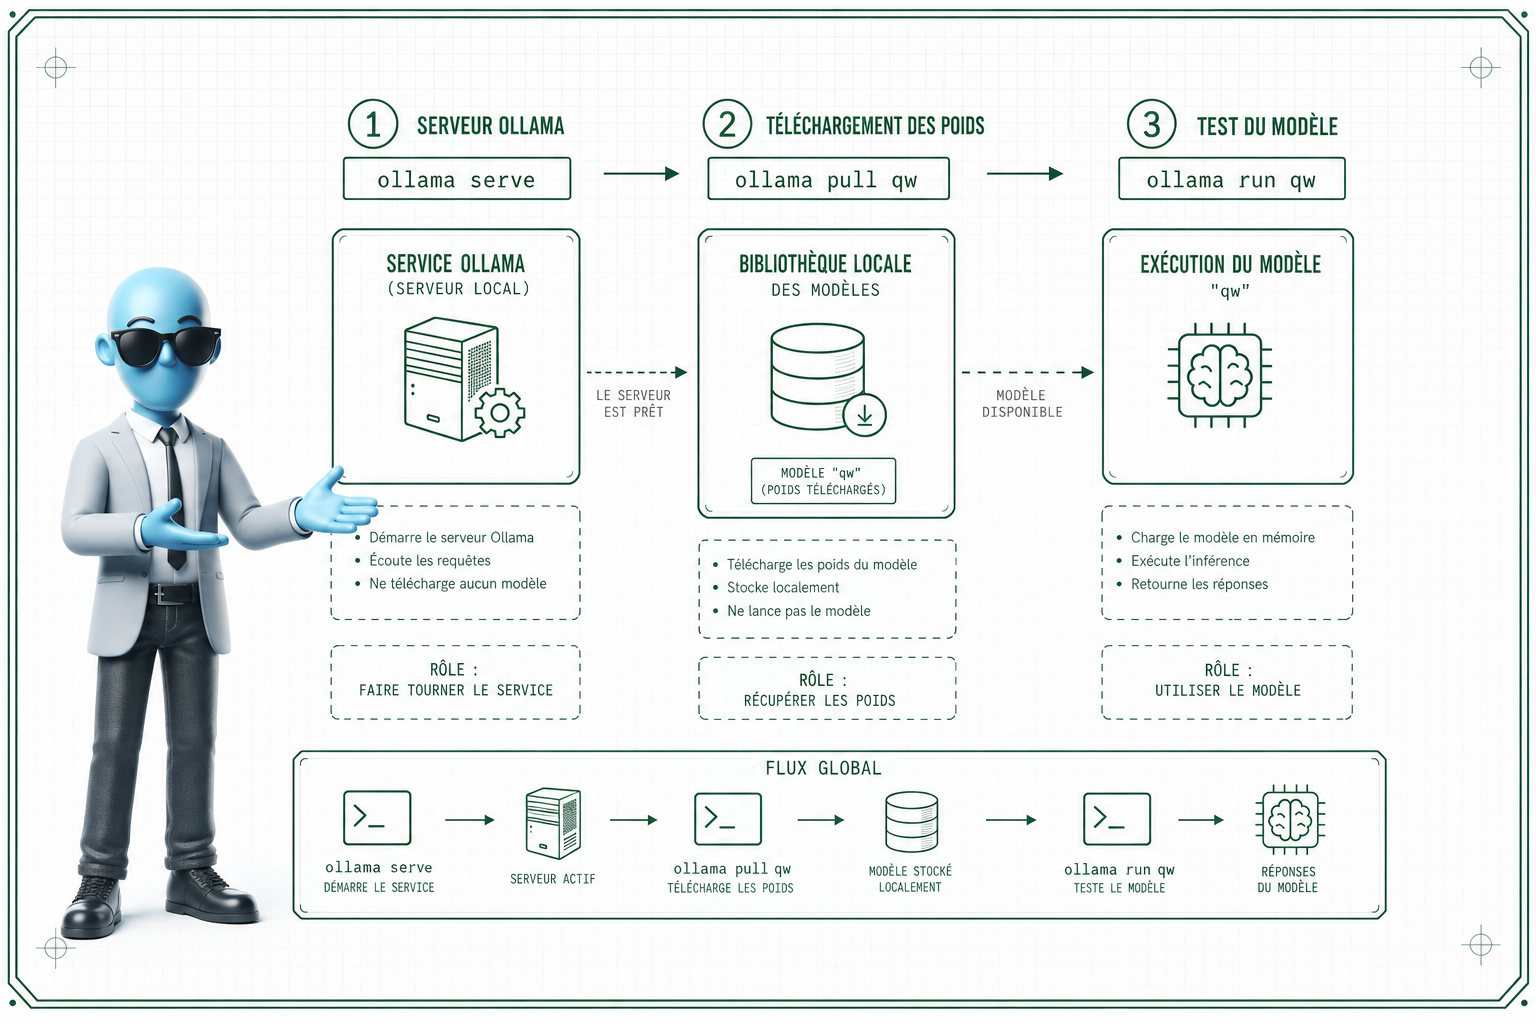
Dans mon flux en trois commandes, c’est la commande 2. Elle prépare juste le modèle en local. Le premier chargement peut prendre du temps, surtout si Ollama doit télécharger plusieurs dizaines de Go puis charger le modèle en mémoire. C’est normal. Sur mon test, la première réponse a été lente, puis les échanges sont devenus beaucoup plus fluides une fois le modèle prêt.
J’utilise cette commande quand Ollama est installé et que je veux lancer le service local tout en récupérant le modèle dans la foulée :
ollama serve & ollama pull qwen3:27bLe point important, c’est le tag du modèle. Ici, j’utilise qwen3:27b, mais le nom exact doit correspondre au modèle disponible dans votre catalogue Ollama. Si ce tag n’existe pas dans votre environnement, remplacez-le par le tag Qwen3 compatible publié dans Ollama. Je ne vous conseille pas d’inventer un nom ou de copier un tag au hasard. L’idée reste la même : charger Qwen3.8-27B, ou une variante équivalente disponible localement.
| Commande | Rôle |
| ollama serve | Démarre le service local Ollama, celui que les outils comme OpenCode peuvent appeler. |
| ollama pull qwen3:27b | Télécharge le modèle sur votre machine. |
| ollama run qwen3:27b | Lance un test rapide pour vérifier que le modèle répond bien. |
Si je veux juste vérifier que tout marche avant de brancher OpenCode, je lance ce test facultatif :
ollama run qwen3:27b
Là, Ollama ouvre une session de chat dans le terminal. Si le modèle répond, c’est bon signe. Vous pouvez ensuite passer à OpenCode et lui demander d’utiliser votre modèle local.
Comment lancer OpenCode avec ce modèle ?
Je lance OpenCode en lui indiquant le modèle Ollama déjà téléchargé, ce qui évite de reconfigurer le fournisseur à la main.
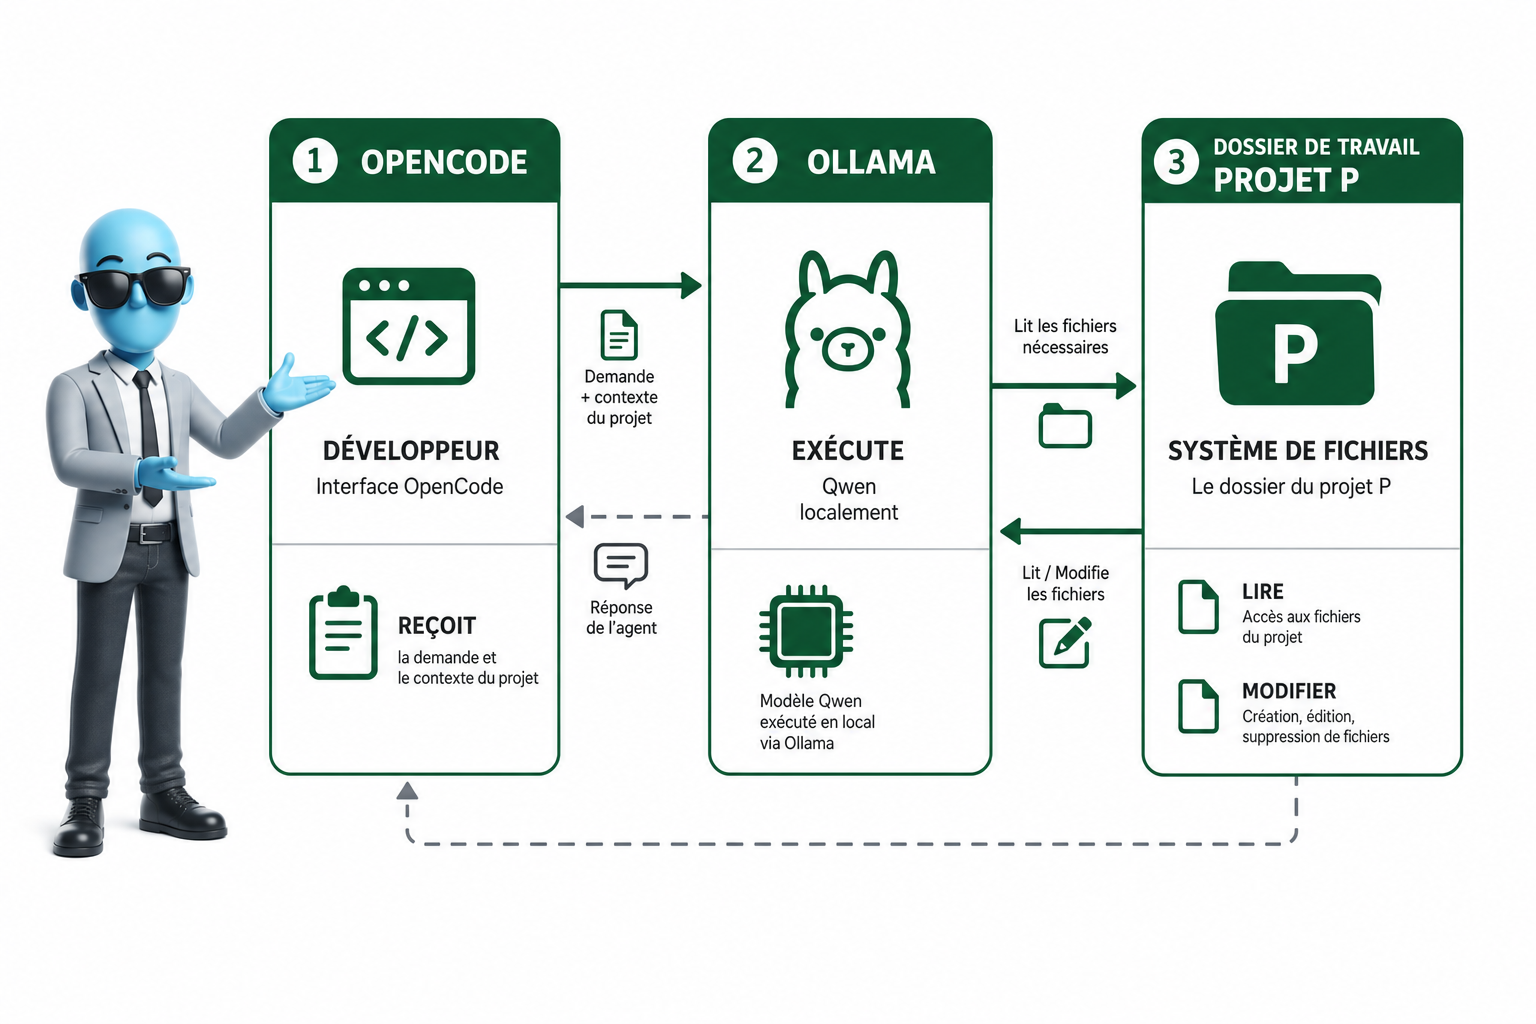
OpenCode, c’est l’interface d’agent de code. En clair, c’est l’outil avec lequel je discute dans mon terminal pour lui demander de lire un projet local, modifier des fichiers, générer du code, expliquer une erreur ou proposer une refacto. Le modèle Qwen tourne via Ollama, et OpenCode sert de couche pratique par-dessus. C’est lui qui fait le lien entre votre dossier de travail et le modèle.
Commande 3
opencode --model ollama/qwen3:27b
Si vous avez utilisé un autre tag Ollama au chapitre précédent, il faut reprendre exactement le même nom après ollama/. C’est bête, mais j’ai déjà vu des installations bloquées juste à cause de ça chez un client.
Par exemple, si votre modèle s’appelle qwen3:latest chez vous, la commande devient :
opencode --model ollama/qwen3:latestPour vérifier que tout marche, je conseille de faire un test dans un dossier vide. Comme ça, vous voyez tout de suite si l’agent arrive à créer des fichiers propres sans risquer de toucher à un vrai projet.
Prompt de test
Crée une petite application Python en ligne de commande qui demande un prénom, affiche un message personnalisé et contient une fonction testable.Le résultat attendu peut ressembler à ça. Le premier fichier contient l’application, avec une fonction séparée pour pouvoir la tester facilement.
main.py
# Petite application Python générée pour tester l’agent local
def build_message(name):
    # On nettoie l’entrée pour éviter les espaces inutiles
    clean_name = name.strip()
    # Si l’utilisateur ne saisit rien, on garde un message simple
    if not clean_name:
        return "Bonjour, inconnu"
    return f"Bonjour, {clean_name}"

def main():
    # On récupère le prénom depuis le terminal
    name = input("Votre prénom : ")
    print(build_message(name))

if __name__ == "__main__":
    main()
Le deuxième fichier vérifie que la fonction réagit bien dans deux cas simples. Un prénom normal, puis une saisie vide.
test_main.py
from main import build_message

def test_build_message_with_name():
    # Vérifie le cas standard
    assert build_message("Franck") == "Bonjour, Franck"

def test_build_message_empty():
    # Vérifie le cas sans prénom
    assert build_message("   ") == "Bonjour, inconnu"
Si OpenCode crée ces fichiers et que le code est cohérent, votre agent local est prêt pour commencer à travailler sur un vrai projet.
Quels résultats attendre au premier test ?
Après le premier chargement, je m’attends à une génération rapide et à un retour assez détaillé sur une petite application Python.
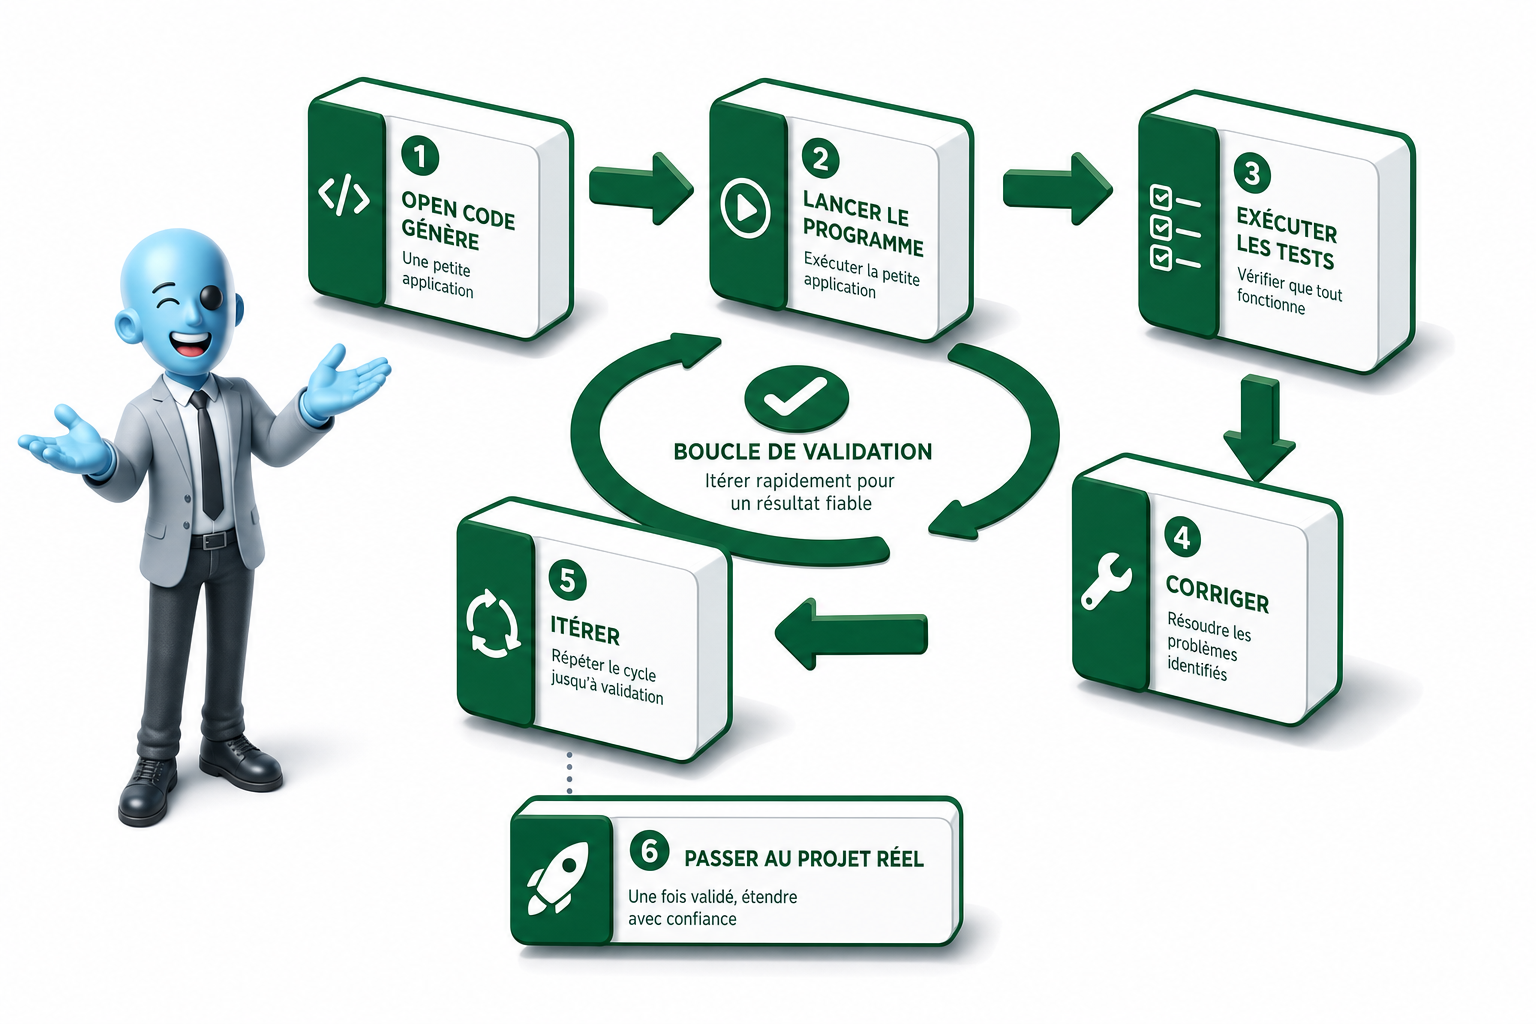
Le tout premier lancement peut donner l’impression que ça rame. C’est normal. Le modèle se charge en mémoire, les poids du modèle sont préparés, et votre machine encaisse le gros du travail au départ. Une fois cette étape passée, l’expérience devient souvent beaucoup plus fluide.
Sur une machine adaptée, avec assez de RAM et idéalement un GPU correct, Qwen3.8-27B utilisé comme agent local peut créer une base de code simple, expliquer ses choix, proposer plusieurs fichiers cohérents, et corriger une erreur basique sans trop tourner en rond. Quand je teste ce genre de setup chez un client, je regarde surtout trois choses : est-ce que le code tourne, est-ce que la structure est propre, et est-ce que l’agent comprend ce qu’il vient de produire.
Pour lancer l’application Python générée, je pars généralement sur la commande la plus simple depuis le dossier du projet :
Lancer l’application
python main.pySi le projet contient des tests et que pytest est installé, je lance aussi la suite de tests tout de suite. Pytest, c’est un outil très courant pour tester du code Python automatiquement.
Lancer les tests
pytestLlama.cpp reste une excellente option si vous voulez contrôler finement le modèle, les paramètres, la quantification, les performances CPU ou GPU. Ça peut être très efficace. Mais ça demande souvent plus de manipulations. Ollama + OpenCode vise plutôt la simplicité ici. Je le vois comme le chemin court pour tester un agent de code local sans passer une demi-journée à configurer l’environnement.
Dans la pratique, voilà ce que je retiens du premier test :
| Avantage | Génération locale rapide après chargement, base de code exploitable, explications souvent utiles. |
| Limite | Premier démarrage parfois lent, qualité variable sur les projets complexes, besoin d’une machine solide. |
| Conseil | Commencer avec une petite application Python, lancer les tests, puis itérer. La confidentialité locale est un vrai bénéfice pratique, même si ça ne remplace pas une vraie politique de sécurité. |
Est ce que ça vaut le coup de le tester localement ?
Pour moi, l’intérêt est clair : Qwen3.8-27B avec Ollama et OpenCode permet de tester un vrai agent de codage local sans partir dans une configuration lourde. Le point à ne pas rater, c’est le matériel. Avec assez de VRAM, l’expérience devient vraiment confortable après le premier chargement. Sans ça, ça peut marcher, mais il faut accepter de la lenteur. Ce flux en trois commandes reste surtout intéressant pour découvrir le codage assisté local, créer de petits projets, tester Python, garder la main sur son environnement. Le bénéfice pour vous : aller vite, sans dépendre d’une stack complexe.
FAQ
- Qwen3.8-27B peut il vraiment tourner en local ?
Oui, à condition d’avoir une machine assez solide. Je recommande surtout de regarder la VRAM GPU. Avec environ 24 Go de VRAM, l’expérience est beaucoup plus confortable. Si une partie du modèle part en RAM système, ça peut fonctionner, mais les réponses seront souvent plus lentes. - Pourquoi utiliser Ollama avec Qwen3.8-27B ?
Ollama simplifie le téléchargement, le lancement et l’exposition du modèle en local. C’est l’intérêt principal ici : éviter une configuration manuelle longue. On installe Ollama, on charge le modèle, puis OpenCode peut l’utiliser comme moteur local. - À quoi sert OpenCode dans cette installation ?
OpenCode joue le rôle d’agent de codage. Il prend le modèle lancé avec Ollama et l’utilise pour générer, modifier ou expliquer du code dans votre projet. En pratique, c’est la couche qui rend le modèle utile pour développer, pas juste discuter dans un terminal. - Le premier lancement est il toujours lent ?
Le premier chargement peut être lent, oui, parce que le modèle doit être téléchargé puis chargé en mémoire. Une fois ce passage fait, les performances sont normalement meilleures sur une machine adaptée. C’est un comportement assez classique avec les gros modèles locaux. - Ollama et OpenCode remplacent ils llama.cpp ?
Pas forcément. llama.cpp reste intéressant quand on veut plus de contrôle et qu’on accepte une configuration plus technique. Le couple Ollama + OpenCode est surtout pratique pour démarrer vite, tester un agent de codage local et éviter de gérer toute l’infrastructure à la main.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent rendre leurs outils data et IA vraiment utilisables, pas juste impressionnants en démo. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez déployer l’IA, l’automatisation ou une stack analytics propre dans votre business, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.