
Claude Opus 5.5 mérite surtout d’être testé sur vos vrais cas d’usage. Le modèle promet un raisonnement toujours actif, des réponses plus rapides et un coût total plus bas. Mais le gain dépend du volume de tokens, de vos prompts et de votre code existant.
Qu’est-ce qui change vraiment ?
Claude Opus 5.5 change surtout la façon de gérer le raisonnement, la vitesse et le coût par tâche. Anthropic le présente comme son nouveau modèle phare, avec un raisonnement désormais systématique, donc le modèle “réfléchit” plus naturellement avant de répondre, même quand la demande paraît simple.
Ce qui m’intéresse surtout, c’est que l’effort de raisonnement par défaut semble plus modéré que sur Opus 5. Dit simplement, le modèle ne sort pas forcément l’artillerie lourde pour résumer un email ou reformuler une note. C’est important parce qu’un gros raisonnement sur une petite tâche, c’est souvent du coût perdu. Et quand le sujet devient vraiment dur, on peut quand même augmenter l’effort.
Je vois ça comme un pilotage par niveau d’effort. Pour une analyse de contrat, je veux un raisonnement fort, parce qu’il faut repérer les clauses ambigües, les risques, les incohérences. Pour un debug complexe, pareil, je préfère payer un peu plus si ça évite trois heures à tourner en rond. Pour générer du code, ça dépend. Une fonction simple n’a pas besoin du même niveau qu’une refonte d’architecture. Pour un résumé de réunion ou un email client, je veux surtout une réponse rapide, propre, courte.
Dans mes missions data et automatisation, je vois souvent le même problème : les équipes ne paient pas seulement le modèle, elles paient leurs prompts mal cadrés, les allers-retours et les sorties trop longues. Un modèle moins cher ne règle pas tout si chaque demande génère 4 réponses inutiles de 800 mots.
Côté prix, Anthropic annonce une baisse du prix par million de tokens d’entrée, de tokens de sortie et des cache reads. Les tokens, c’est juste les morceaux de texte lus ou générés par le modèle. Les cache reads, c’est quand le modèle réutilise du contexte déjà chargé au lieu de tout relire à plein tarif.
Le vrai point, c’est ça : l’économie globale annoncée autour de 40 % dépend surtout du nombre de tokens consommés par tâche, pas uniquement du prix unitaire. Si vos prompts sont propres, vos sorties cadrées et votre cache bien utilisé, là ça commence à devenir intéressant.
| Changement | Impact | Point à vérifier |
| Raisonnement toujours actif | Réponses plus solides sur les tâches complexes | Est-ce utile sur vos tâches simples ? |
| Effort par défaut plus modéré | Moins de consommation inutile | Le niveau par défaut suffit-il vraiment ? |
| Baisse des coûts unitaires | Moins cher à volume égal | Vos volumes de tokens restent-ils stables ? |
| Cache reads moins chers | Meilleur coût sur les contextes répétés | Votre app utilise-t-elle bien le cache ? |
| Économie globale dépendante des tokens | Gain réel si les prompts sont cadrés | Combien de tokens partez-vous par tâche ? |
Le modèle est-il vraiment plus rapide ?
Claude Opus 5.5 est annoncé comme plus rapide de plus de 30 %, et oui, ça compte vraiment dès qu’on l’utilise dans un agent ou dans une boucle de travail quotidienne. La vitesse, ce n’est pas juste du confort. Ça change ce qu’on peut faire sans rendre l’expérience pénible.
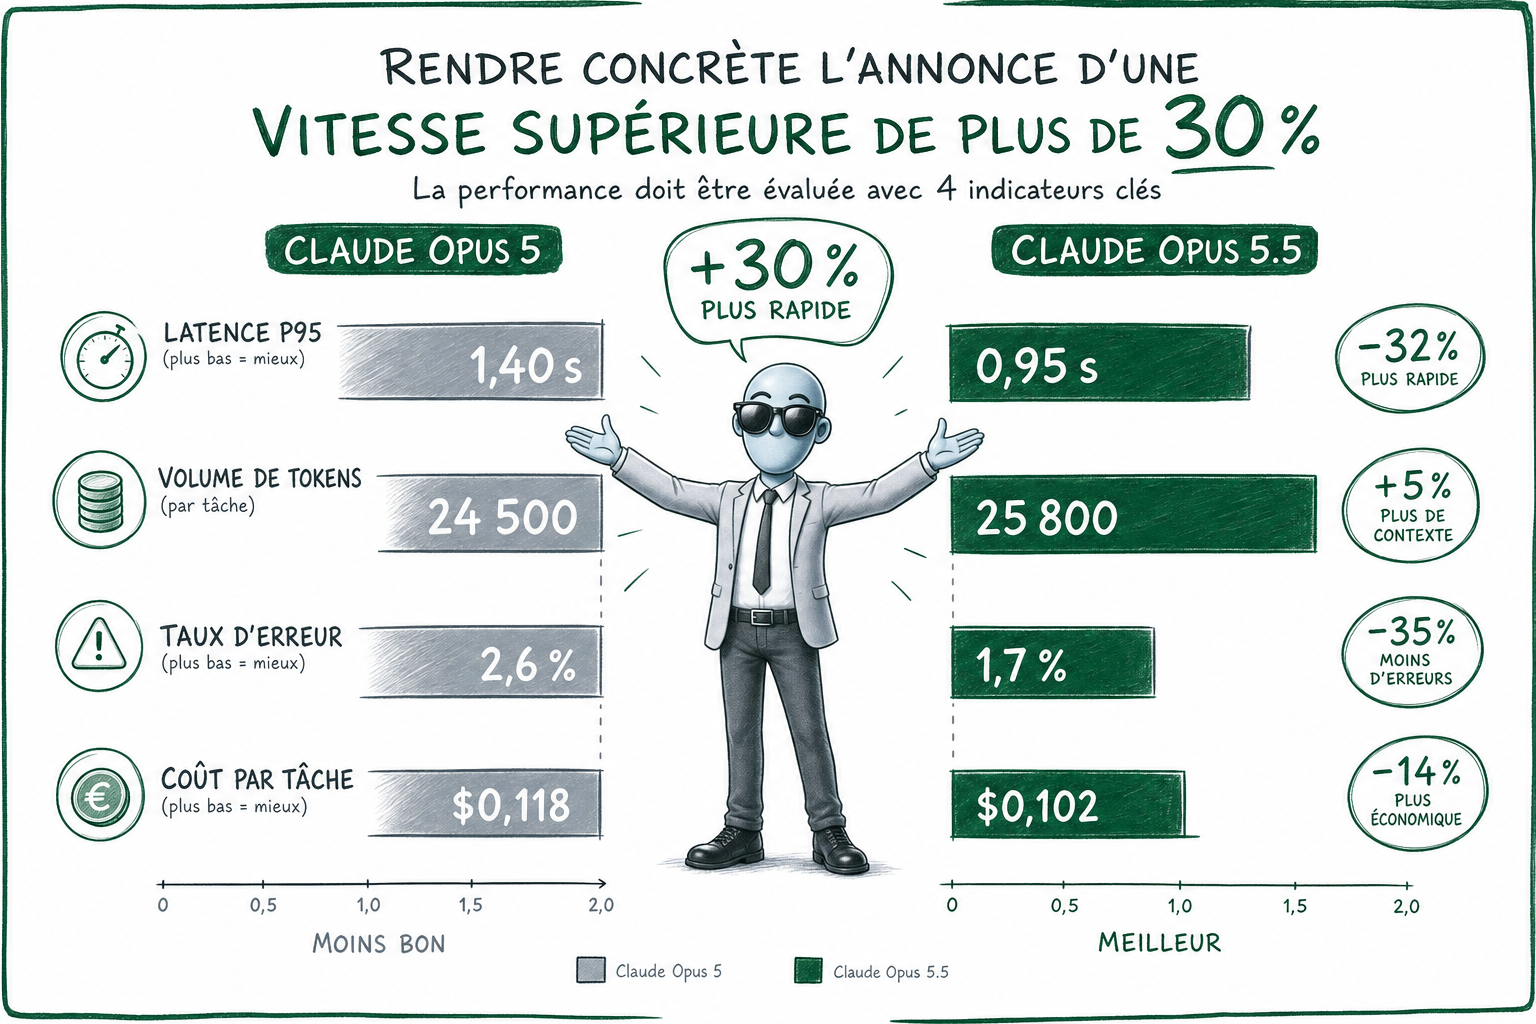
Quand un assistant de développement répond plus vite, le dev reste dans son flux. Quand un agent de correction traite 200 tickets, quelques secondes gagnées par appel deviennent vite des minutes. Même logique pour la génération de rapports, les demandes internes, les workflows n8n ou les automatisations qui enchaînent plusieurs appels LLM. Un LLM, c’est juste le modèle qui lit une entrée et génère une réponse. Dès qu’on l’appelle 5, 10 ou 20 fois dans un même scénario, la latence devient un vrai sujet produit.
Par contre, plus rapide ne veut pas dire moins cher. C’est le piège classique. Si votre agent faisait 2 appels avant, puis qu’il en fait 10 parce que c’est plus fluide et qu’on a ajouté des étapes, la facture peut monter. Même si chaque réponse arrive plus vite. Le coût dépend surtout du nombre d’appels et du volume de tokens, c’est-à-dire les morceaux de texte envoyés au modèle et générés par lui.
Avant migration, je mesurerais ça proprement sur un petit protocole simple :
- La latence moyenne, pour voir le ressenti global.
- La latence p95, pour voir les cas lents. P95 veut dire que 95 % des appels sont plus rapides que cette valeur.
- Les tokens en entrée et en sortie.
- Le taux d’erreur et le taux de réponses bloquées.
- La qualité métier perçue, notée par les utilisateurs ou l’équipe.
- Le coût par tâche complète, pas seulement par appel.
Ce genre de log suffit souvent pour décider sans débat théorique. Le code reste volontairement générique, parce que chaque API expose ses champs différemment.
import time

def run_logged_call(prompt_id, model_name, prompt, call_model, price_input, price_output):
    start = time.time()
    status = "ok"
    tokens_input = 0
    tokens_output = 0

    try:
        response = call_model(model_name, prompt)

        # Récupérez ces valeurs depuis votre fournisseur quand elles existent.
        tokens_input = response.get("tokens_input", 0)
        tokens_output = response.get("tokens_output", 0)

    except Exception:
        status = "error"

    duration = time.time() - start

    # Estimation simple basée sur vos prix par token.
    estimated_cost = (tokens_input * price_input) + (tokens_output * price_output)

    log_line = {
        "prompt_id": prompt_id,
        "model": model_name,
        "duration_seconds": round(duration, 3),
        "tokens_input": tokens_input,
        "tokens_output": tokens_output,
        "status": status,
        "estimated_cost": round(estimated_cost, 6),
    }

    return log_line
Je ne migrerais jamais un modèle en production sur la base d’un benchmark vendeur uniquement. Je testerais d’abord les 20 ou 30 tâches qui coûtent cher, qui sont lentes, ou qui cassent facilement. C’est là qu’on voit si Opus 5.5 vaut vraiment le coup.
Quels risques pour votre code existant ?
Le principal risque, c’est la compatibilité, surtout si vos intégrations Opus 5 reposent sur des réglages précis de raisonnement ou sur d’anciens outils. Certaines configs pensées pour Opus 5 peuvent casser avec Opus 5.5, notamment si le raisonnement était désactivé, si vos tool calls attendent un format très strict, ou si vous utilisez encore des outils legacy pas vraiment documentés.
Je le vois souvent chez les clients. Le modèle n’est pas forcément “moins bon”. C’est juste que tout l’écosystème autour était fragile. Un prompt trop implicite, un JSON attendu au caractère près, un garde-fou maison, et d’un coup la migration ressemble à une panne.
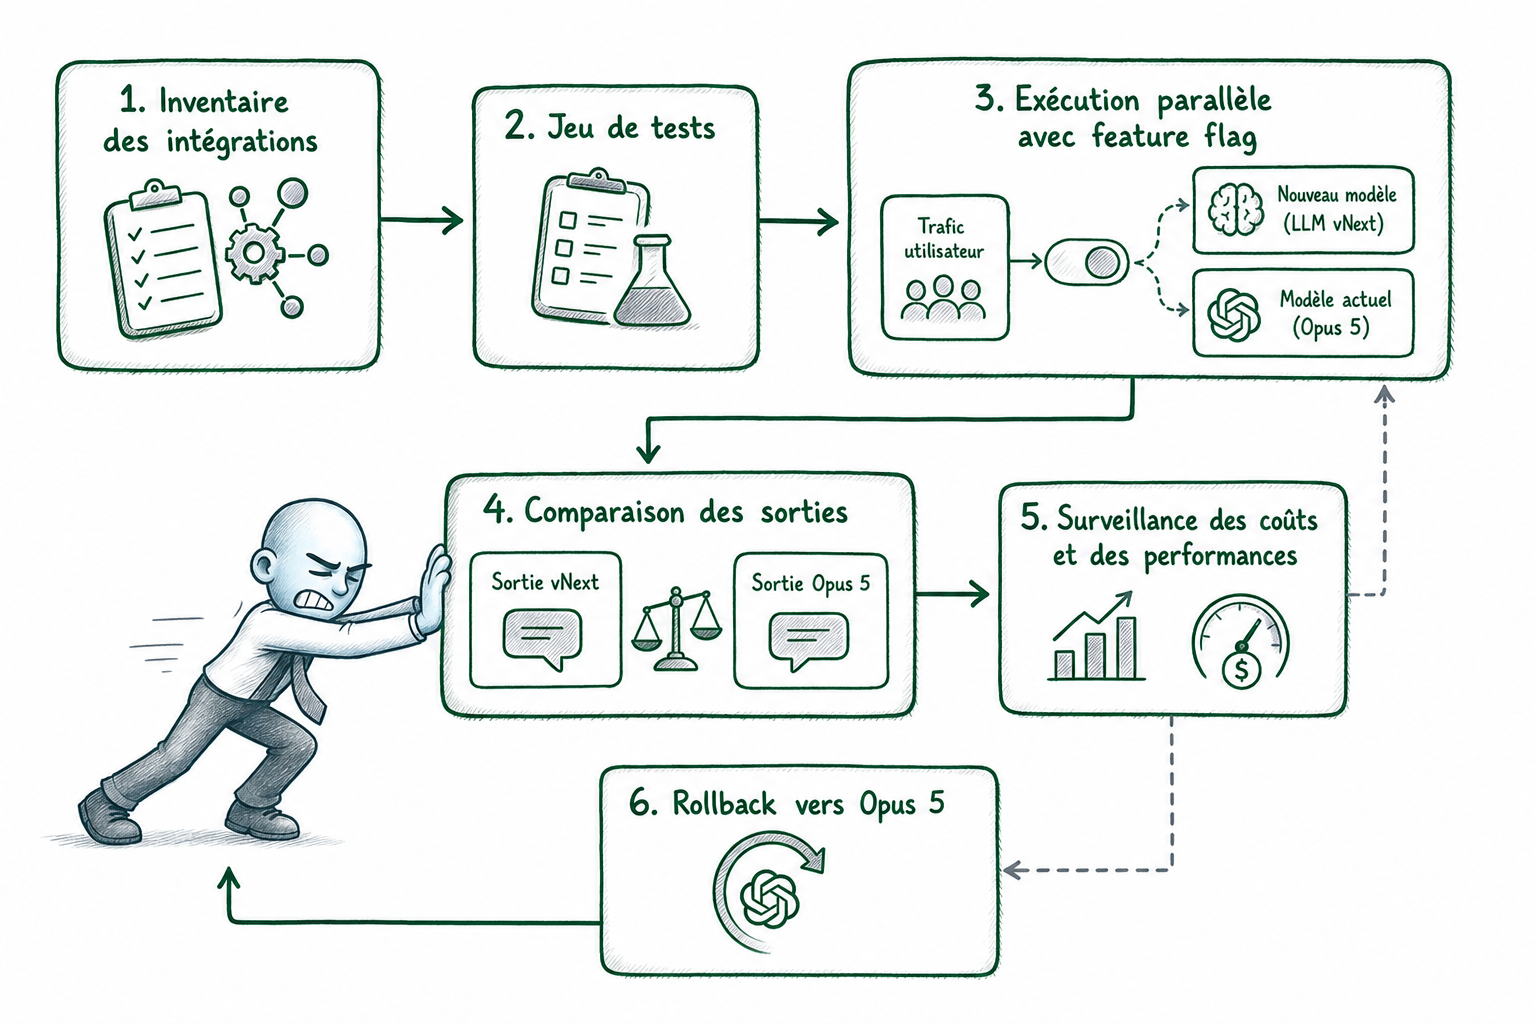
- Inventorier tous les endpoints et workflows qui appellent le modèle.
- Repérer les prompts critiques, ceux qui touchent au support, au légal, au code ou à la vente.
- Identifier tous les tool calls, fonctions, agents, connecteurs et anciens outils.
- Tester les cas où le raisonnement était désactivé ou fortement contraint.
- Comparer les sorties sur un jeu de tests stable, pas juste “à l’œil”.
- Vérifier les refus liés à la sécurité, parce qu’un modèle plus prudent peut bloquer des cas utiles.
- Surveiller le coût par tâche après migration, pas seulement le coût par token.
La bonne approche, c’est une migration progressive. Je mets un feature flag, je fais tourner Opus 5 et Opus 5.5 en parallèle sur un échantillon, je compare automatiquement les réponses, puis je garde un rollback rapide vers Opus 5 si un seuil qualité ou coût est dépassé.
Ce wrapper ne dépend d’aucune librairie Anthropic précise. Il sert à poser une base adaptable, avec variable d’environnement, mode test, logs et fallback.
import os
import logging

logging.basicConfig(level=logging.INFO)

MODEL_PRIMARY = os.getenv("LLM_MODEL_PRIMARY", "opus-5-5")
MODEL_FALLBACK = os.getenv("LLM_MODEL_FALLBACK", "opus-5")
TEST_MODE = os.getenv("LLM_TEST_MODE", "false") == "true"

def call_provider(model, prompt, tools=None):
    # Remplacer ici par le vrai client validé dans votre stack
    if TEST_MODE:
        return {"model": model, "text": f"Réponse simulée avec {model}"}
    raise NotImplementedError("Brancher ici l'appel fournisseur vérifié")

def run_llm(prompt, tools=None):
    try:
        logging.info("Appel modèle primaire: %s", MODEL_PRIMARY)
        response = call_provider(MODEL_PRIMARY, prompt, tools)
        return response
    except Exception as error:
        logging.warning("Fallback vers %s après erreur: %s", MODEL_FALLBACK, error)
        return call_provider(MODEL_FALLBACK, prompt, tools)
Chez les clients, le problème vient rarement du modèle seul. Il vient du prompt, des garde-fous, du format de sortie attendu et du fait qu’on n’a pas de jeu de tests. Une migration vers Opus 5.5 doit ressembler à une mise à jour logicielle sérieuse, pas à un changement de nom dans une variable.
La qualité rédactionnelle progresse-t-elle ?
Claude Opus 5.5 semble viser des réponses plus claires, plus directes et plus conformes aux consignes. Et franchement, c’est là que ça devient utile en entreprise. Pas parce qu’il fait de jolies phrases. Parce qu’il peut aider sur des trucs très concrets : comptes rendus, mails clients, résumés de réunions, notes internes, synthèses de documents, reformulations courtes.
Un bon modèle rédactionnel ne doit pas seulement “bien écrire”. Il doit respecter le format demandé, éviter les détours, garder le bon niveau de détail et ne pas transformer une demande simple en roman. C’est souvent là que les équipes perdent du temps. On demande 5 lignes, on reçoit 40 lignes. On demande un ton client, on reçoit un ton trop corporate. On demande une synthèse, on reçoit une dissertation.
Dans le quotidien, si Claude Opus 5.5 progresse vraiment sur ce point, le gain est assez simple à comprendre :
- Moins de retouches sur les mails et les notes internes.
- Moins de temps perdu à recadrer les réponses.
- Plus de cohérence dans les livrables produits par différentes personnes.
- Moins de friction quand on l’intègre dans un workflow automatisé.
J’ai déjà vu ça chez un client : le problème n’était pas que le modèle écrivait mal. Le problème, c’est qu’il écrivait trop. Trop long, trop prudent, trop bavard. À grande échelle, ça devient pénible. Donc une meilleure discipline rédactionnelle, c’est un vrai sujet business.
Côté sécurité, le contenu mentionne aussi une nouvelle couche inspirée de Fable, avec des protections autour de la cybersécurité, de la biologie et de la distillation. Je reste prudent ici, parce qu’on n’a pas assez d’éléments pour détailler les mécanismes techniques. Ce qu’il faut retenir, c’est qu’une autre version du modèle peut prendre le relais si une demande est bloquée.
Opérationnellement, ça veut dire qu’il faut surveiller les refus, comprendre quand une substitution a lieu, et vérifier que l’expérience reste stable pour l’utilisateur. Si un assistant répond différemment selon le modèle appelé en arrière-plan, ça peut créer de la confusion.
| Cas d’usage | Ce qu’on attend du modèle | Comment tester |
| Email client | Un message clair, poli, court, avec le bon ton. | Donner une situation client réelle et limiter la réponse à 8 lignes. |
| Compte rendu | Une synthèse structurée avec décisions et actions. | Fournir une transcription de réunion et demander 3 sections maximum. |
| Note interne | Un texte simple, utile, sans jargon inutile. | Demander une version lisible par une équipe non technique. |
| Résumé de réunion | Les points clés sans perdre les nuances importantes. | Comparer le résumé avec les décisions réellement prises. |
| Réponse support | Une réponse précise, rassurante, sans inventer. | Tester avec un ticket incomplet et vérifier qu’il pose les bonnes questions. |
Peut-on faire confiance aux benchmarks ?
Les benchmarks donnent une tendance, pas une preuve suffisante pour décider une migration. C’est utile pour se faire une première idée, oui. Mais je ne baserais jamais un changement de modèle là-dessus, surtout si ça touche du code, du support client, du juridique ou des process internes.
Les scores publiés comparent Claude Opus 5.5 à Claude Opus 5 et à GPT-6 Astra, avec des progrès annoncés sur plusieurs tests de codage et de travail bureautique. Le point important, c’est que ces résultats viennent du vendeur. Dans le contenu disponible, ils ne sont pas vérifiés indépendamment. Donc je les lis comme un signal marketing intéressant, pas comme une vérité terrain.
Le piège, je l’ai vu plusieurs fois chez des clients. Un modèle cartonne sur un benchmark de code, puis devient beaucoup moins impressionnant sur de vrais tickets Jira, avec des conventions maison, une vieille base Node, des règles métier implicites et trois exceptions juridiques dans chaque phrase. Un benchmark mesure une performance standardisée. Votre entreprise, elle, ne travaille jamais dans un environnement standardisé.
Pour tester proprement, je prendrais un petit lot de tâches réelles. Pas des prompts inventés pour faire joli. Des tickets, des emails, des specs, des demandes support, des bouts de documentation. J’anonymise tout ce qui est sensible, puis je compare Opus 5 et Opus 5.5 avec exactement la même consigne.
- Je mesure la qualité de sortie.
- Je mesure le temps de réponse.
- Je mesure les tokens consommés, c’est-à-dire le volume de texte envoyé et généré.
- Je mesure le coût par tâche.
- Je mesure le taux de correction humaine.
- Je mesure le taux de rejet, quand la réponse est inutilisable.
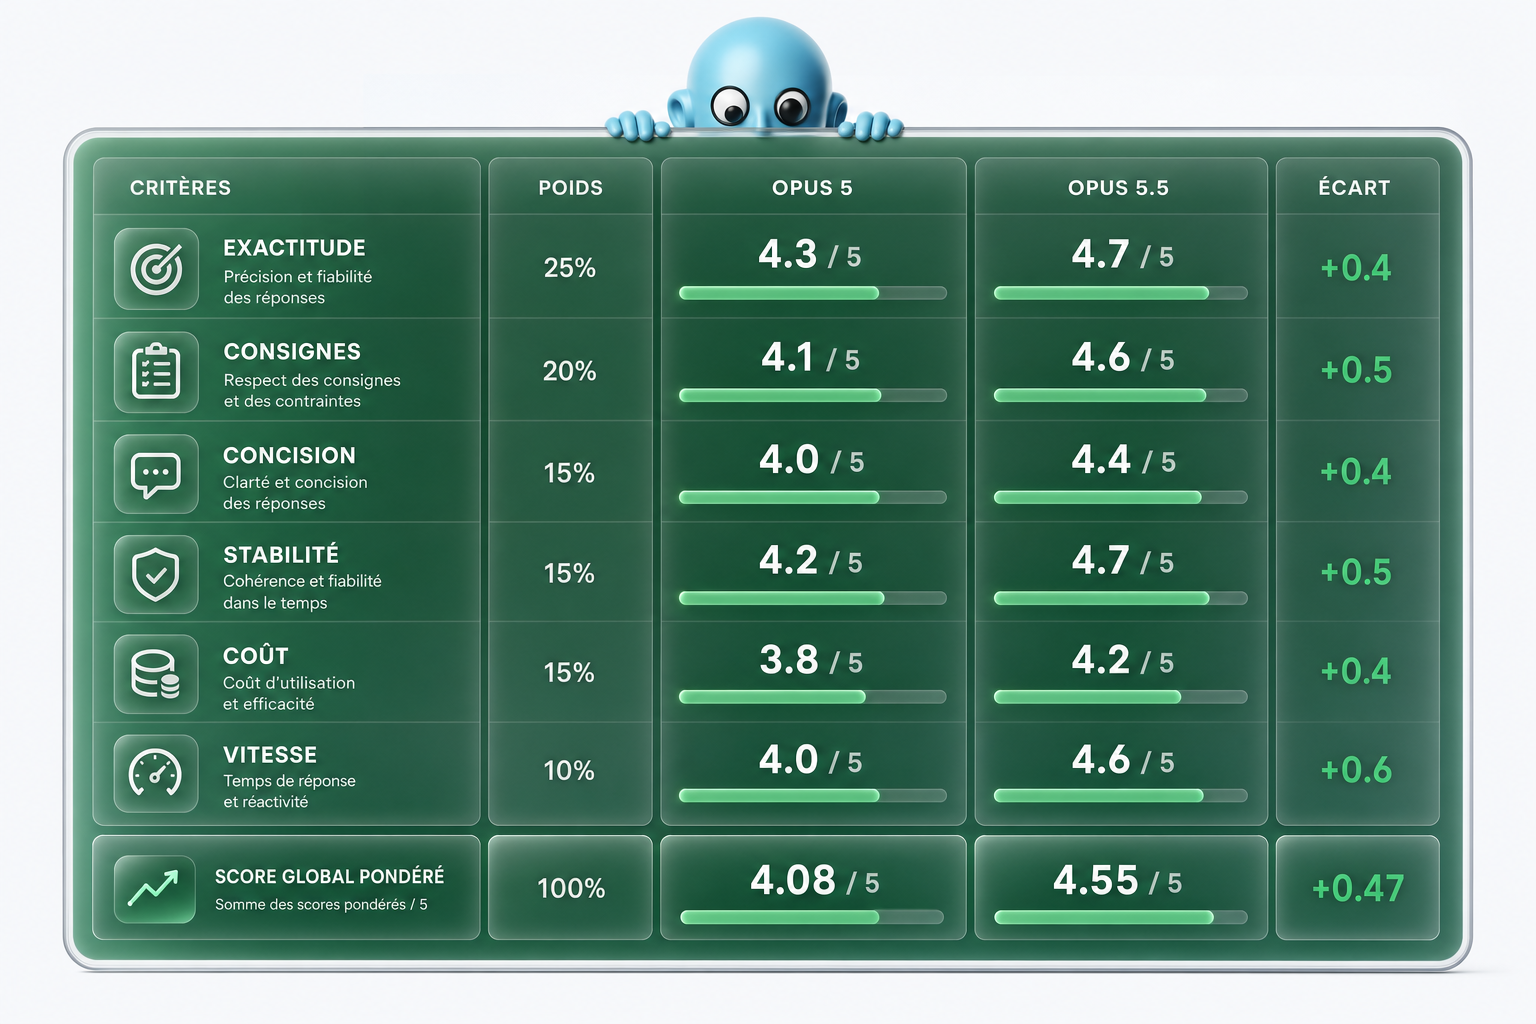
| Critère | Opus 5 | Opus 5.5 |
| Exactitude /5 | ||
| Respect des consignes /5 | ||
| Concision /5 | ||
| Stabilité du format /5 | ||
| Coût /5 | ||
| Vitesse /5 |
Si Claude Opus 5.5 réduit vraiment les tokens par tâche tout en gardant une meilleure qualité, là oui, il peut devenir intéressant. Mais la seule façon propre de le savoir, c’est de le tester sur vos workflows. Pas sur une capture de benchmark.
Alors, est-ce que je migrerais vers Claude Opus 5.5 ?
Je migrerais vers Claude Opus 5.5 uniquement après un vrai test sur mes cas d’usage. Les promesses sont intéressantes : raisonnement toujours actif, vitesse annoncée en hausse, coût total potentiellement plus bas, meilleure qualité rédactionnelle et progrès sur le code. Mais le sujet n’est pas juste le prix du token. C’est le coût par tâche, la stabilité de vos prompts, la compatibilité avec votre code existant et la qualité réelle en production. Si vous mesurez tout ça proprement, vous pouvez décider vite, sans vous raconter d’histoire. Le bénéfice pour vous : moins de coûts cachés et une IA plus fiable au quotidien.
FAQ
- Claude Opus 5.5 est-il moins cher que Claude Opus 5 ?
Il est annoncé avec des prix unitaires plus bas sur les tokens d’entrée, les tokens de sortie et les cache reads. Mais le vrai coût dépend surtout du nombre de tokens consommés par tâche. Si vos prompts sont longs ou si vos agents multiplient les appels, la facture peut rester élevée. - Pourquoi le raisonnement toujours actif est important ?
Parce que le modèle applique systématiquement une forme de raisonnement, avec un effort par défaut plus modéré. C’est utile pour garder de la qualité sans surpayer chaque tâche simple. Pour les cas complexes, vous pouvez augmenter l’effort, à condition de mesurer l’impact sur le coût. - Claude Opus 5.5 est-il adapté au code ?
Oui, c’est l’un des usages mis en avant, notamment avec une vitesse de réponse plus élevée et de meilleurs résultats annoncés sur certains benchmarks de codage. Je conseillerais quand même de tester vos vrais tickets, vos conventions et vos tool calls avant de migrer en production. - Quels tests faire avant de passer à Claude Opus 5.5 ?
Je testerais la latence, les tokens consommés, le coût par tâche, la qualité des réponses, le respect du format, les refus de sécurité et la compatibilité avec le code existant. Le plus simple : comparer Opus 5 et Opus 5.5 sur un jeu de tâches réelles et stables. - Les benchmarks publiés suffisent-ils pour décider ?
Non. Ils donnent une direction, mais ils viennent du vendeur et ne remplacent pas vos propres mesures. Un benchmark peut montrer un progrès moyen, alors que votre cas d’usage précis peut mieux ou moins bien fonctionner. Le test terrain reste indispensable.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de l’organisme Formations Analytics. J’accompagne des entreprises sur le tracking avancé server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA dans les process business et le SEO/GEO. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez tester, cadrer ou industrialiser l’IA dans vos équipes sans exploser les coûts, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.