
DeepSeek-V4.1-Flash change surtout l’économie du très long contexte. Le sujet n’est pas juste le score benchmark, c’est le coût réel d’un agent IA qui lit beaucoup, garde son état, puis répond sans exploser la mémoire.
Pourquoi ce modèle attire autant l’attention ?
DeepSeek-V4.1-Flash attire l’attention parce qu’il vise un problème très concret : Le coût des agents IA qui tournent longtemps, relisent beaucoup de contexte, manipulent des documents énormes et doivent garder le fil.
Dans les projets agents, je le vois souvent : Ce qui coûte cher, ce n’est pas toujours la réponse finale. C’est tout ce que l’agent doit relire, maintenir en mémoire, comparer, résumer, puis recharger avant même de répondre. Quand vous avez des logs, des tickets, des contrats, des captures d’écran et de l’historique métier, l’inférence devient vite le vrai sujet.
Le modèle repose sur une architecture MoE de 552B de paramètres. MoE veut dire “Mixture of Experts”, donc mélange d’experts. L’idée est simple : Le modèle possède un très grand réservoir de capacités, mais il n’active qu’une partie des paramètres à chaque étape. Ici, DeepSeek annonce 8B de paramètres actifs pendant le prefill, c’est la phase où le modèle lit le prompt, puis 16B pendant le decode, c’est la phase où il génère la réponse.
| Élément | Rôle |
| MoE 552B | Grand réservoir de capacité, mais activation partielle |
| 8B prefill | Lecture du prompt moins coûteuse |
| 16B decode | Génération plus concentrée |
| 1M tokens | Contexte très long pour agents et documents massifs |
La différence entre paramètres totaux et paramètres actifs est importante. Les 552B représentent la capacité globale disponible. Les 8B ou 16B représentent ce qui travaille réellement à un moment donné. C’est comme avoir une grande équipe d’experts, mais ne mobiliser que les bons profils selon la tâche. Ça ne rend pas le modèle magique, mais ça peut changer l’économie d’usage.
L’autre point qui mérite d’être regardé, c’est la fenêtre de contexte de 1 million de tokens, avec entrée texte et images. Le modèle est entraîné sur 45T tokens multimodaux, donc du texte et du visuel. Il annonce aussi un cache KV global de 890 octets par token. Le cache KV, c’est la mémoire technique utilisée par le modèle pour éviter de recalculer toute l’attention à chaque génération. Plus il est compact, plus les longs contextes deviennent réalistes.
Enfin, il y a Engram, un composant de mémoire conditionnelle de 196B. L’idée est d’ajouter une mémoire activée selon le besoin, pas de tout charger en permanence. Pour moi, l’intérêt de cette release est là : Moins dans le score de benchmark du jour, plus dans la manière dont DeepSeek attaque le coût réel de l’IA longue durée.
Pourquoi séparer prefill et decode ?
Séparer prefill et decode, c’est surtout mieux aligner le calcul sur l’usage réel d’un agent IA. Un agent lit souvent énormément avant de produire peu, ou moyennement. Il avale un historique, des documents, des tickets, des observations, parfois une mémoire complète. Puis il répond en quelques paragraphes, ou il déclenche une action.
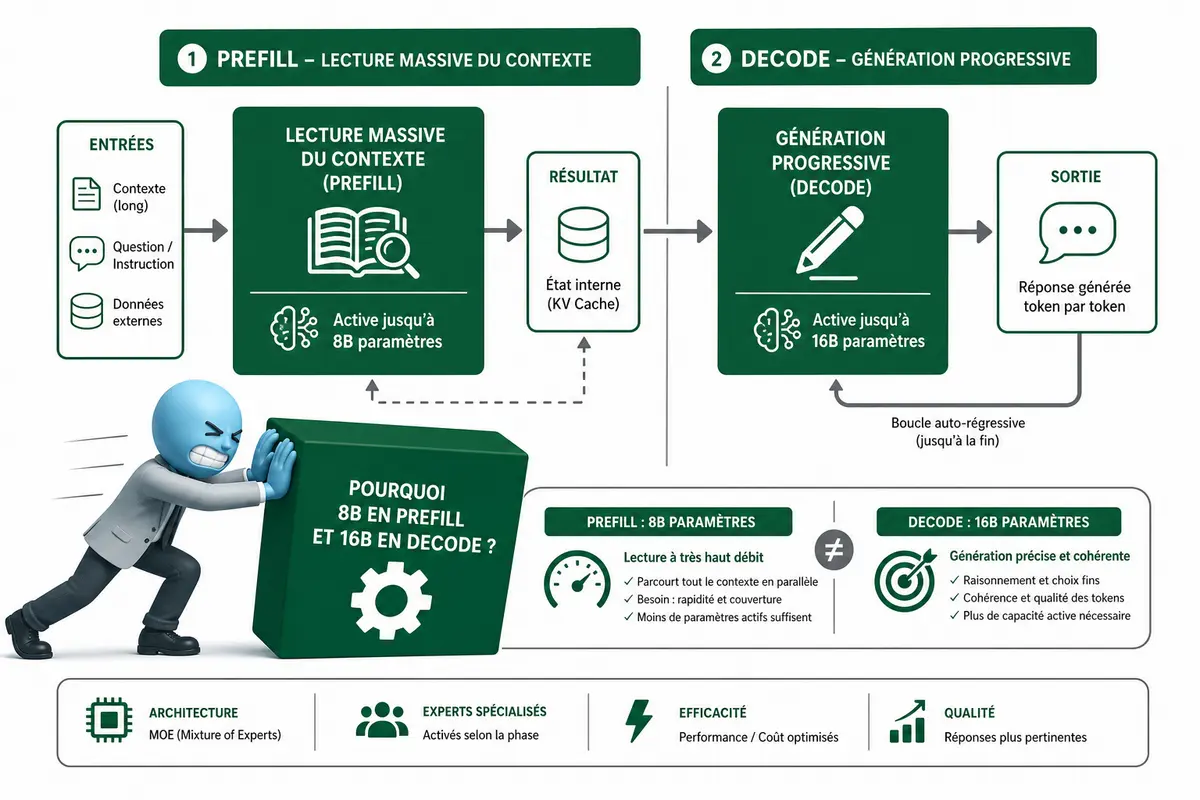
Dans une architecture Causal Encoder-Decoder, l’idée est assez simple. La partie “encoder” sert à comprendre et compresser le contexte. C’est la phase de lecture. La partie “decoder” sert à produire la réponse, token par token. Un token, c’est un morceau de texte, souvent un bout de mot. Donc quand le modèle écrit une phrase, il la construit progressivement, morceau par morceau.
- Prefill : lecture massive du contexte, documents, historique, images ou consignes.
- Decode : production progressive de la réponse.
- Intérêt : ne pas payer le même prix pour lire et pour écrire.
Ce que je trouve intéressant avec DeepSeek-V4.1-Flash, c’est le choix très concret derrière ça. Le modèle active 8B de paramètres pendant le prefill, puis 16B pendant le decode. Les paramètres, pour faire simple, ce sont les “réglages internes” du modèle, ceux qui portent sa capacité à comprendre, raisonner et générer. Donc ici, le message est clair : lire moins cher, puis mobiliser plus de capacité au moment où il faut formuler, raisonner finement ou prendre une décision.
Ça colle très bien aux agents longue durée. Un agent support, par exemple, peut devoir parcourir l’historique client, les anciens tickets, la base de connaissance, les règles internes, puis proposer une réponse propre. Un assistant data peut lire des schémas de tables, des logs, des requêtes passées, puis suggérer une analyse. Dans ces cas-là, le coût ne devrait pas exploser juste parce que le contexte est gros.
Les architectures où lecture et génération consomment trop souvent le même type de ressources ont un profil de coût moins sain. On paie fort pour absorber, puis on paie fort pour écrire. Là, la séparation rend le système plus pragmatique. Et franchement, sur des cas clients avec beaucoup de contexte, c’est souvent là que la facture commence à faire mal.
Comment le cache KV devient plus léger ?
Le cache KV devient plus léger grâce à une combinaison assez concrète : Compressed Sparse Attention 2, FP4 KV caching, et une conception pensée pour réduire la pression sur la mémoire HBM, la mémoire très rapide des GPU.
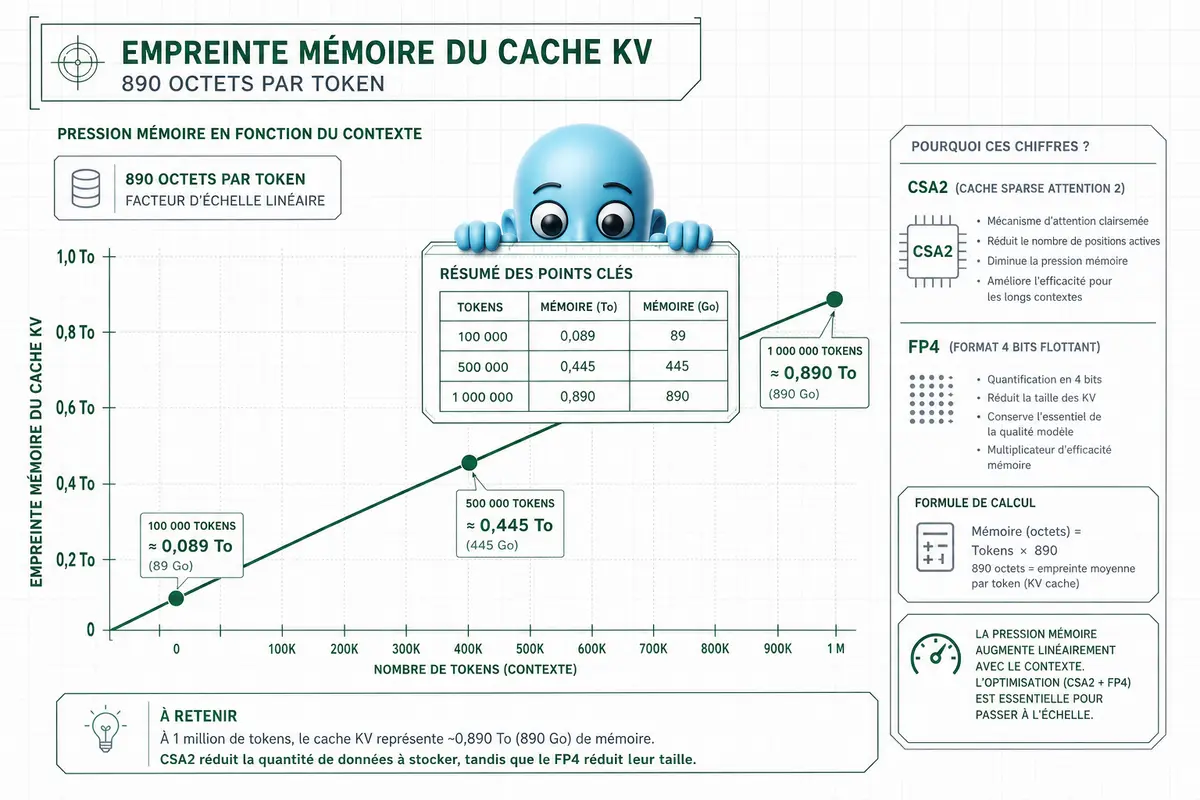
Le cache KV, dit simplement, c’est la mémoire de travail du modèle. À chaque nouveau token généré, le modèle n’a pas envie de recalculer tout l’historique depuis le début. Il garde donc en cache des informations appelées Key et Value, d’où KV. Plus le contexte est long, plus ce cache grossit, et plus il devient critique.
Avec DeepSeek-V4.1-Flash, le chiffre important, c’est un cache KV global de 890 octets par token. Dit comme ça, ça paraît abstrait. Mais sur une fenêtre de contexte de 1 million de tokens, chaque octet compte. On ne parle plus juste d’un modèle qui “réfléchit”. On parle d’un système qui doit stocker, relire et déplacer énormément de données en permanence.
| Technique | Effet recherché |
| CSA2 | Réduire le travail d’attention sur très long contexte |
| FP4 KV caching | Diminuer la taille du cache KV |
| Cache global 890 octets par token | Rendre le contexte massif plus viable |
| Réduction HBM | Limiter le coût mémoire en inférence |
CSA2, pour Compressed Sparse Attention 2, sert à éviter que l’attention fasse toujours le même travail lourd sur tout le contexte. L’idée, sans rentrer dans des maths inutiles ici, c’est de mutualiser, compresser et dédupliquer une partie du travail d’attention. Sur un contexte court, l’écart peut sembler secondaire. Sur un million de tokens, ça change complètement la donne.
Le FP4 KV caching, lui, réduit la précision utilisée pour stocker le cache KV. FP4 veut dire qu’on encode certaines valeurs sur 4 bits. C’est moins précis qu’un format classique, mais beaucoup plus compact. Et si c’est bien maîtrisé, on gagne énormément en empreinte mémoire sans casser l’usage.
Sur le terrain, je le vois souvent : on parle beaucoup GPU, nombre de cartes, puissance brute. Mais en déploiement IA, la mémoire et la bande passante finissent vite par dicter la facture. Sur les longs contextes, le problème n’est pas seulement de calculer vite. C’est surtout de déplacer les bonnes données assez vite, sans saturer la HBM.
À quoi sert la mémoire Engram ?
Quand je regarde Engram, je ne le vois pas comme une “mémoire magique”. Je le vois plutôt comme une réponse à un problème très concret des agents IA : comment garder de l’état sans bourrer toute l’historique dans le contexte brut à chaque appel.
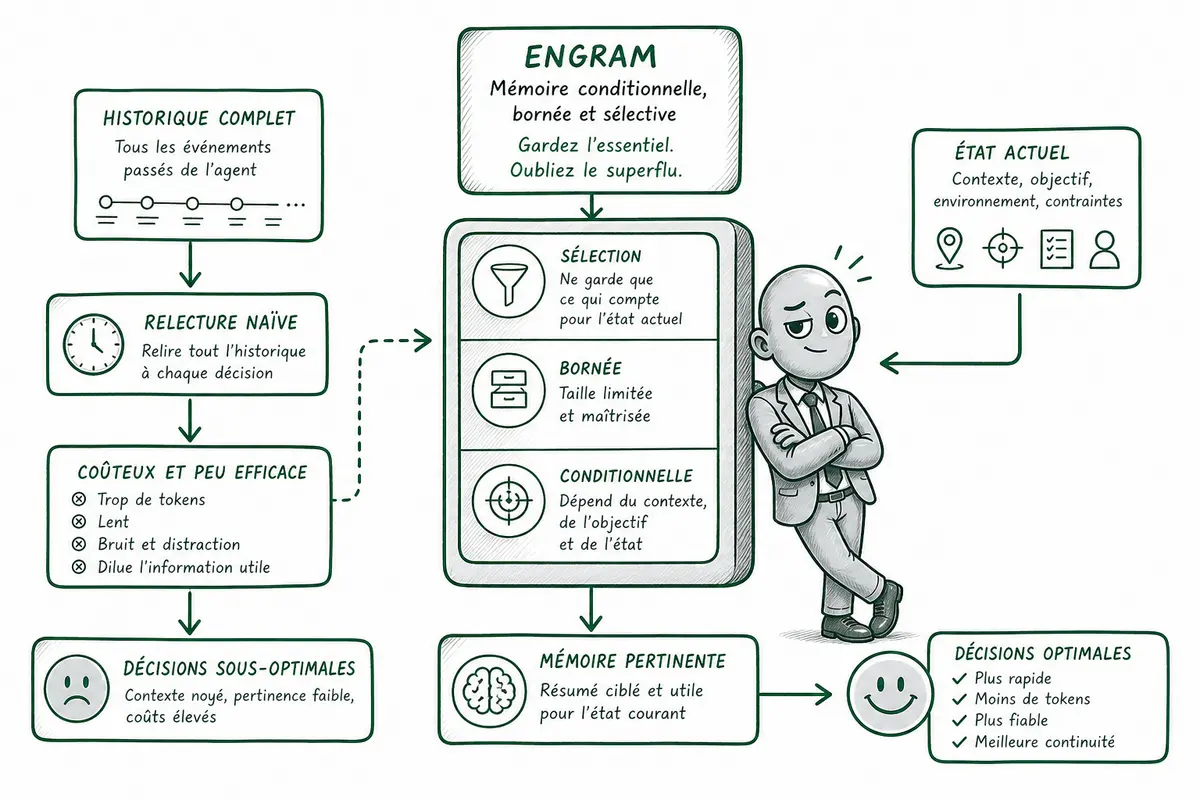
Engram, c’est présenté comme un composant de 196B dédié à la mémoire conditionnelle. Dit simplement, l’idée est de mieux décider ce que l’agent doit conserver, rappeler ou utiliser selon la situation. Pas de tout réinjecter naïvement dans la fenêtre de contexte, comme on le voit encore trop souvent dans des architectures d’agents un peu bricolées.
Et ça, c’est important parce que le maintien de l’état agent coûte cher. Cher en tokens, cher en latence, cher en complexité. Un agent longue durée qui doit suivre des objectifs, des préférences, des fichiers, des échanges précédents ou des signaux multimodaux ne peut pas juste tout relire en permanence. À un moment, ça devient lent, instable, et franchement pénible à exploiter.
J’ai vu ça chez des clients. Au début, ils gardent beaucoup d’historique parce que la qualité semble monter. L’agent se souvient de plus de choses, il paraît plus pertinent. Puis les factures augmentent, les réponses ralentissent, et la qualité finit parfois par baisser parce que le modèle se retrouve avec trop de bruit. Sans stratégie mémoire, plus de contexte ne veut pas toujours dire meilleure intelligence.
- Engram : Mémoire conditionnelle de 196B, pensée pour gérer ce qui mérite vraiment d’être conservé ou rappelé.
- SWA Bounded Replay : Logique de relecture bornée, donc une manière de maîtriser ce que l’agent relit pour maintenir son état, sans prétendre détailler un mécanisme interne qui n’est pas documenté ici.
- Single-Pass mHC : Brique orientée efficacité, utile pour éviter des passages multiples coûteux quand on manipule un contexte massif ou multimodal.
- Objectif commun : Rendre les agents longue durée moins chers, moins lents, et plus réalistes à faire tourner en production.
Ce qui m’intéresse ici, ce n’est pas le nom des briques. C’est le fait qu’elles ciblent les vrais irritants des agents IA : mémoire, relecture, coût de maintien de l’état, et passage à l’échelle. Ça sonne moins sexy qu’une démo parfaite, mais c’est exactement là que les systèmes sérieux se jouent.
Que faut il surveiller avant de l’utiliser ?
Je surveillerais surtout la disponibilité réelle, les conditions d’usage, la stabilité en production, la latence, le coût d’inférence et la qualité sur des cas longs réels. Les caractéristiques annoncées sont impressionnantes, oui. Mais un modèle ne se juge pas sur une fiche technique. Il se juge dans vos workflows.
Ce qui m’intéresse avec DeepSeek-V4.1-Flash, c’est de voir s’il tient quand on lui demande de faire des choses vraiment lourdes : des agents qui lisent beaucoup avant d’agir, des assistants multimodaux qui mélangent texte et images, de l’analyse documentaire massive, de la mémoire persistante, de l’automatisation business avec plusieurs étapes. C’est là que les promesses se vérifient ou se cassent.
Les benchmarks ne suffisent pas. Surtout pour une architecture pensée pour réduire le coût du long contexte. Le long contexte, c’est la capacité à traiter beaucoup d’informations dans une même requête. Sur le papier, c’est génial. En production, ça peut coûter cher, consommer beaucoup de mémoire, ou devenir lent si l’architecture ne suit pas.
| Point à tester | Pourquoi c’est important |
| Coût du prefill | Les agents lisent souvent beaucoup avant d’agir |
| Coût du decode | La génération reste le moment visible pour l’utilisateur |
| Cache KV | Le long contexte dépend fortement de la mémoire |
| Mémoire Engram | L’état agent doit rester utile sans devenir ingérable |
| Multimodal | Texte et images changent les contraintes d’inférence |
Dans une équipe data ou IA, je testerais simple. Des prompts longs. Des documents réels. Des sessions agent qui durent. Je mesurerais séparément le prefill, donc la phase où le modèle lit le contexte, et le decode, donc la phase où il génère la réponse. Je suivrais aussi la mémoire consommée, parce que le cache KV, c’est souvent là que le long contexte devient coûteux.
Je comparerais la qualité avec et sans mémoire persistante. La mémoire Engram, si elle est bien exploitable, doit aider l’agent à garder un état utile sans accumuler du bruit. J’ai déjà vu des systèmes “à mémoire” devenir moins fiables simplement parce qu’ils retenaient trop de choses inutiles.
Je n’inventerais aucun résultat avant test. DeepSeek-V4.1-Flash est intéressant si son architecture permet vraiment de faire tourner des agents plus longs, moins chers et plus stables. Le vrai sujet, pour la conclusion, ce n’est pas d’avoir le modèle le plus spectaculaire. C’est d’avoir une architecture exploitable.
Est ce que DeepSeek-V4.1-Flash annonce une IA plus exploitable ?
DeepSeek-V4.1-Flash est intéressant parce qu’il parle de coût, de mémoire et d’architecture, pas seulement de performance affichée. Le modèle cherche à rendre les longs contextes et les agents IA longue durée plus réalistes, avec un prefill moins coûteux, un decode séparé, un cache KV réduit, CSA2, FP4, Engram et des mécanismes pour mieux gérer l’état. Je ne le verrais pas comme une promesse magique. Je le verrais comme un signal clair : la prochaine bataille de l’IA se joue sur l’inférence efficace. Pour vous, le bénéfice est simple : construire des agents plus longs, plus utiles et potentiellement moins chers à faire tourner.
FAQ
- Qu’est-ce que DeepSeek-V4.1-Flash apporte vraiment ?
DeepSeek-V4.1-Flash apporte surtout une approche d’architecture pensée pour réduire le coût des longs contextes et des agents IA longue durée. Son intérêt vient du prefill moins coûteux, du cache KV réduit, de l’attention compressée et d’une mémoire conditionnelle appelée Engram. - Pourquoi le prefill est si important pour les agents IA ?
Le prefill correspond à la phase où le modèle lit le contexte, les documents, l’historique ou les observations. Pour un agent, cette phase peut coûter très cher parce qu’il lit souvent beaucoup avant de répondre. Réduire ce coût rend les agents plus viables. - À quoi sert le cache KV dans un modèle long contexte ?
Le cache KV garde une partie des informations déjà calculées pour éviter de tout recalculer à chaque nouveau token. Sur un contexte très long, sa taille devient un facteur critique de mémoire, de bande passante et donc de coût d’inférence. - Pourquoi CSA2 et FP4 KV caching sont importants ?
CSA2 vise à réduire et mutualiser une partie du travail d’attention. FP4 KV caching réduit l’empreinte du cache KV. Les deux vont dans le même sens : rendre le très long contexte moins lourd en mémoire et moins coûteux à exploiter. - Faut-il choisir un modèle IA uniquement sur ses benchmarks ?
Je ne le conseille pas. Les benchmarks donnent un signal, mais pour les agents IA et les longs contextes, il faut aussi mesurer le coût du prefill, la latence, la mémoire, la qualité sur des cas réels et la stabilité sur des sessions longues.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes data, marketing et produit sur des sujets très concrets : mesurer proprement, automatiser intelligemment, intégrer l’IA sans empiler des gadgets. Avec webAnalyste et Formations Analytics, j’ai travaillé pour des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez cadrer un projet IA, agent ou automatisation business, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.