
Aucun système ne gagne dans tous les cas. Les deux configurations génèrent à une vitesse proche, mais le cluster DGX Spark traite les longs prompts bien plus vite. Je compare leurs performances, leur architecture, les effets du logiciel et du cache, puis les coûts pour vous aider à choisir selon votre charge réelle.
Quelle configuration gagne sur les premiers tests ?
Aucun des deux systèmes ne l’emporte systématiquement. Sur les premiers tests avec DeepSeek V4 Flash, les résultats changent selon qu’on mesure la génération des réponses ou le traitement initial du prompt.
La comparaison porte sur un Mac Studio M5 Ultra doté de 256 Go de mémoire unifiée et sur deux NVIDIA DGX Spark de 128 Go chacun, reliés en RDMA. Le RDMA (« Remote Direct Memory Access ») permet aux machines d’échanger des données directement entre leurs mémoires, avec moins d’intervention du processeur.
| Mesure | Mac Studio M5 Ultra | Deux DGX Spark |
| Génération observée | Environ 34 à 38 tokens par seconde | Environ 34 à 38 tokens par seconde |
| Traitement initial d’un contexte de 32 000 tokens | Environ 44 à 50 secondes | Environ 17 secondes |
Les débits de génération sont proches dans ces essais. Le traitement du prompt, lui, avantage nettement les deux Spark : ils ingèrent le contexte de 32 000 tokens en environ 17 secondes, contre 44 à 50 secondes pour le Mac. Il ne faut pas confondre ces deux phases. Le temps d’ingestion correspond au traitement du prompt avant la réponse ; les tokens par seconde décrivent la génération qui suit.
Le choix dépend donc de votre usage. Si vos requêtes contiennent de longs contextes, les deux Spark sont plus rapides sur cette mesure. Si votre priorité est la génération, les débits observés ne départagent pas clairement les configurations. Ces résultats restent liés à DeepSeek V4 Flash, au logiciel utilisé et à la charge de test. Ils ne permettent pas de conclure qu’une configuration sera toujours plus rapide sur d’autres modèles ou scénarios.
Comment les deux DGX Spark travaillent-ils ensemble ?
Les deux DGX Spark ne fusionnent pas automatiquement en une seule machine. Pour exécuter un modèle trop volumineux pour un seul Spark, on répartit ses poids et ses calculs entre les deux GPU avec le parallélisme tensoriel.
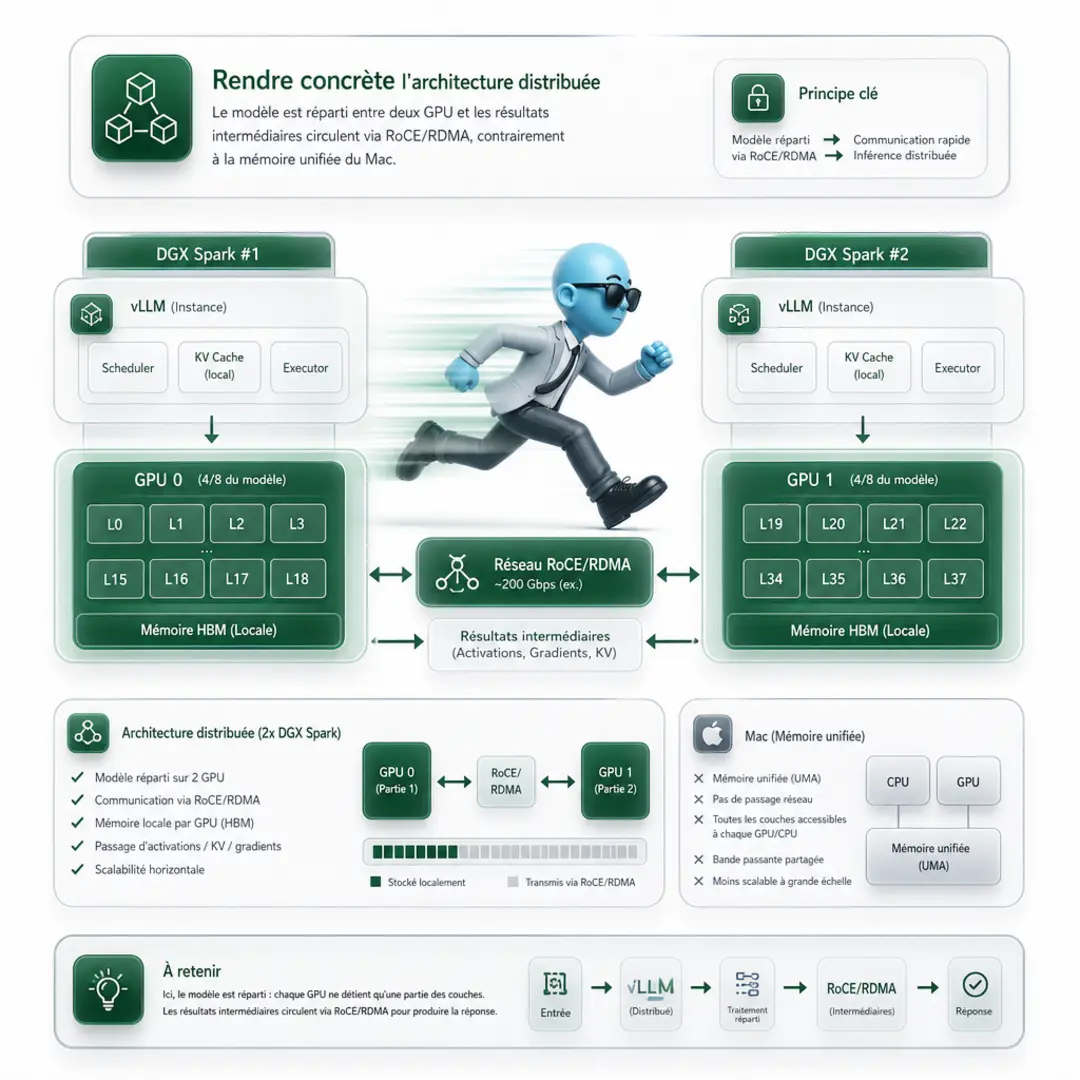
Avec vLLM, chaque GPU héberge une partie du modèle. À chaque token généré, les GPU échangent des résultats intermédiaires pour poursuivre le calcul ensemble. Ces échanges passent par RoCE, une technologie qui transporte RDMA sur Ethernet. RDMA permet de transférer des données entre machines avec peu de copies et de charge sur le processeur. La liaison est annoncée à 200 Go/s ; les mesures pratiques sont d’environ 111 Go/s. Ce sont deux valeurs distinctes : l’une est la valeur annoncée, l’autre le débit observé.
Cette répartition permet de charger un modèle comme DeepSeek V4 Flash, trop volumineux pour tenir dans la mémoire d’un seul Spark. La capacité mémoire des deux machines devient exploitable pour un même modèle, mais le partage n’est pas gratuit : les échanges entre GPU ajoutent une dépendance à la latence et au débit de la liaison.
Sur un Mac doté d’une mémoire unifiée suffisante, le modèle est chargé dans un espace mémoire partagé par le CPU et le GPU. On évite alors la communication entre deux machines, mais on reste limité à la mémoire disponible sur ce Mac. Les deux architectures répondent donc à des contraintes différentes : capacité distribuée côté Spark, mémoire centralisée côté Mac.
Cette architecture compte surtout sur les longs prompts. Le modèle et le cache KV — la mémoire des clés et valeurs conservées pour traiter le contexte déjà lu — peuvent être répartis entre les deux GPU. Ça permet de dépasser la capacité d’un Spark seul et de traiter des contextes plus longs. Le débit réel dépend ensuite du volume d’échanges par token : une liaison rapide aide, mais ne supprime pas le coût du parallélisme.
Pourquoi les longs prompts favorisent-ils les DGX Spark ?
Les deux DGX Spark disposent de davantage de puissance de calcul parallèle pour traiter le prefill des longues entrées. C’est ce qui les avantage quand le prompt contient un gros volume de contexte, par exemple un codebase complet.
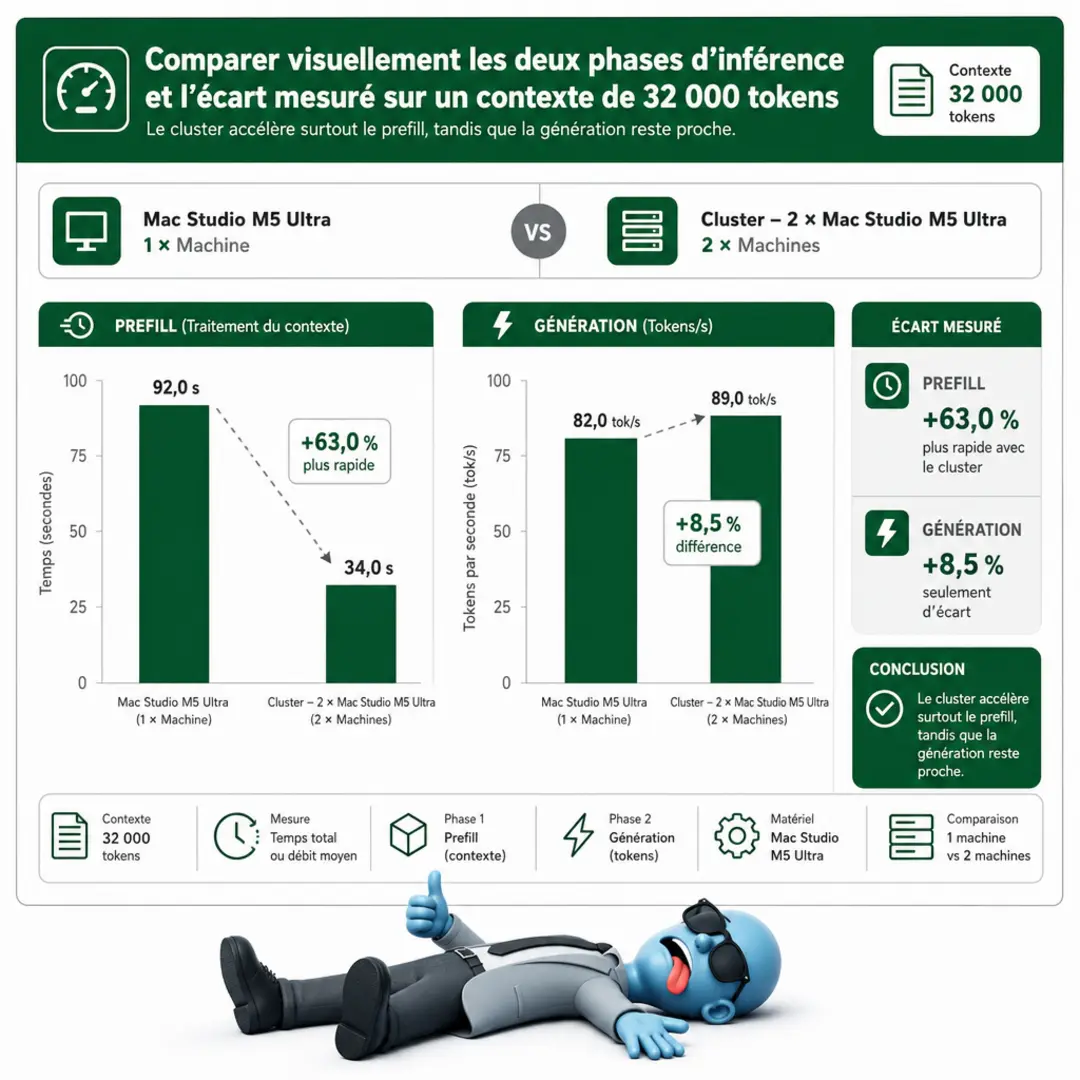
L’inférence d’un modèle se déroule en deux phases. Le prefill traite le prompt initial et calcule les représentations de tous ses tokens. Cette phase dépend surtout de la capacité à effectuer beaucoup d’opérations en parallèle. La génération, elle, produit les tokens un par un. Elle dépend davantage de la bande passante mémoire : à chaque étape, le modèle doit accéder à ses poids pour calculer le token suivant.
Sur un codebase d’environ 32 000 tokens, les mesures disponibles indiquent près de 17 secondes pour le cluster de deux DGX Spark, contre 44 à 50 secondes pour le Mac. L’écart porte donc surtout sur le traitement initial du contexte. Il ne signifie pas que le cluster sera toujours plus rapide sur l’ensemble d’une réponse : sur certains modèles, le Mac peut générer les tokens plus vite une fois le prefill terminé.
La comparaison dépend aussi du moteur d’inférence, c’est-à-dire du logiciel qui exécute le modèle sur le matériel. Sur Mac, passer de llama.cpp à MLX améliore les performances. Les résultats obtenus avec llama.cpp ne reflètent donc pas nécessairement ce que le Mac peut atteindre avec une pile logicielle optimisée pour Apple Silicon.
Le cache de prompts réduit également l’écart pour les requêtes répétées. Il conserve une partie du calcul déjà effectué sur un préfixe identique, ce qui évite de retraiter tout le contexte à chaque demande. Sur un workflow où le même codebase sert de contexte à plusieurs questions, le cluster perd donc une partie de son avantage initial. Pour une première requête avec un long prompt, les DGX Spark restent mieux placés ; pour des échanges répétés ou une génération soutenue, le résultat dépend davantage du modèle, du moteur et du matériel utilisé.
Comment choisir selon votre usage et votre budget ?
Le choix dépend du type de charge, du nombre d’utilisateurs, du logiciel utilisé et de la répétition des prompts. Il n’y a pas de vainqueur universel : deux DGX Spark en cluster et un Mac M5 Ultra ne répondent pas exactement aux mêmes contraintes.
Le cluster est adapté aux longues entrées et aux modèles trop volumineux pour tenir sur un seul Spark. Il peut répartir la charge entre les deux machines, avec une communication via RDMA, un mécanisme de transfert rapide entre appareils. Le Mac peut rester efficace avec plusieurs utilisateurs et générer plus vite sur certains modèles. Ces écarts dépendent du modèle, de sa quantification — sa représentation numérique compressée — et du logiciel d’inférence.
Sur Apple Silicon, MLX est un framework d’apprentissage automatique optimisé pour les puces Apple. Ses performances comptent dans la comparaison : un même modèle peut se comporter différemment selon le moteur utilisé. Le cache de prompts compte aussi. Il conserve le calcul associé à un préfixe déjà traité, ce qui peut réduire le temps de traitement des longues entrées quand les requêtes réutilisent le même contexte. Si les prompts changent à chaque appel, le gain est moindre. Il faut donc tester avec vos propres modèles et vos vrais scénarios, pas seulement comparer un débit théorique.
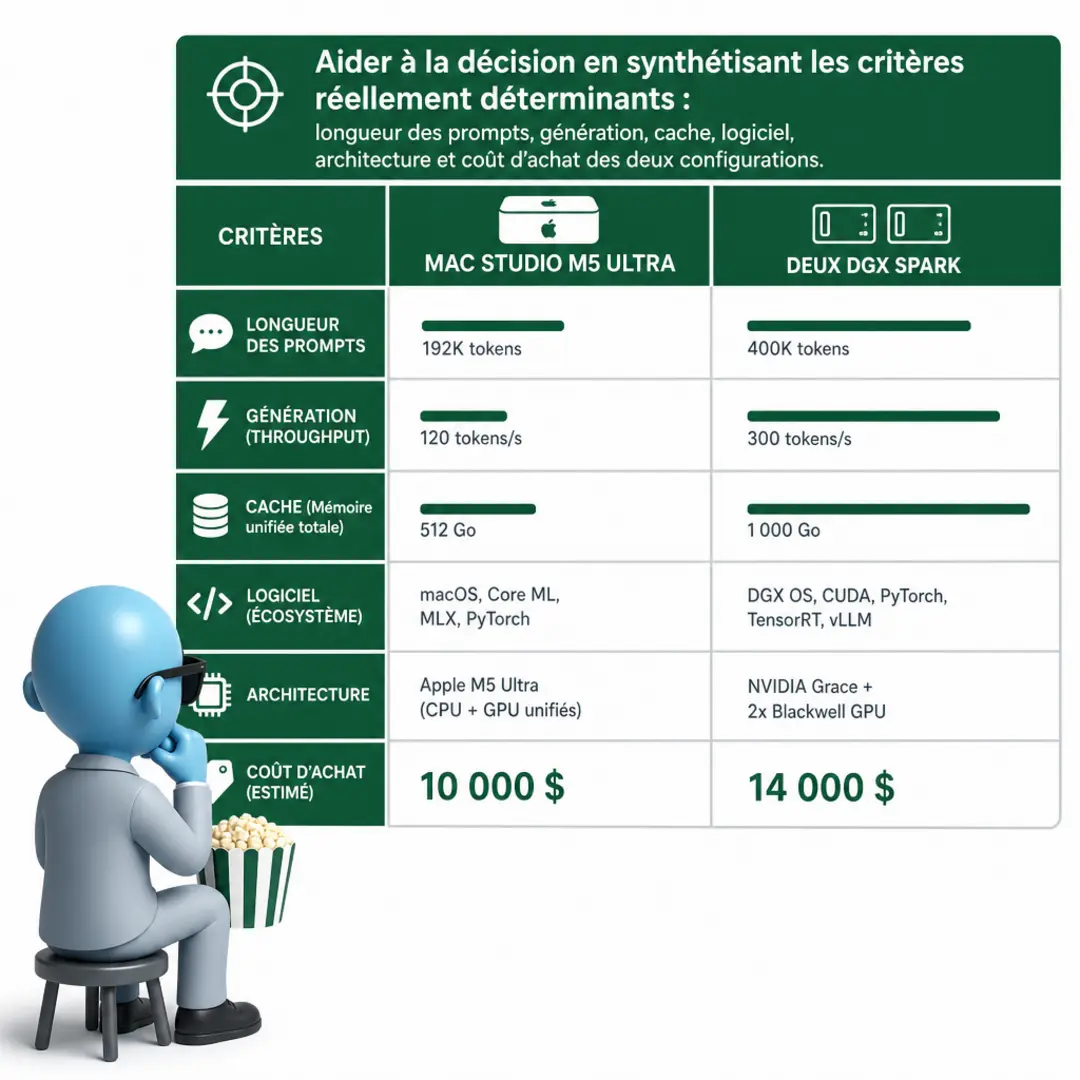
Les configurations évaluées coûtent environ 14 000 dollars pour le Mac et 10 000 dollars pour les deux Spark. Le câble RDMA s’ajoute au coût du cluster, sans montant fourni ici. Je comparerais d’abord les coûts d’achat connus, puis les résultats sur vos charges représentatives, sans extrapoler les coûts d’exploitation ou les capacités non mesurées.
Pour trancher, vérifiez ces critères :
- Le cluster est pertinent si vos entrées sont longues ou si le modèle dépasse les capacités d’un Spark seul.
- Le Mac mérite d’être testé si la génération, le traitement multi-utilisateur ou l’écosystème MLX sont centraux.
- La répétition des prompts doit refléter votre usage réel pour mesurer l’effet du cache.
| Critère | M5 Ultra | Deux DGX Spark |
| Architecture | Mac autonome | Cluster, câble RDMA en supplément |
| Longues entrées | À mesurer selon le modèle | Adapté à cette charge |
| Génération | Peut être plus rapide sur certains modèles | Dépend du modèle et du logiciel |
| Coût indiqué | Environ 14 000 dollars | Environ 10 000 dollars, hors câble RDMA |
Quelle configuration répond vraiment à votre charge ?
Le M5 Ultra et deux DGX Spark répondent à des besoins différents. Sur DeepSeek V4 Flash, leurs débits de génération restent proches, autour de 34 à 38 tokens par seconde, mais le cluster traite bien plus vite les longues entrées. Son avantage repose sur le parallélisme tensoriel et la liaison RDMA ; celui du Mac tient notamment à sa mémoire unifiée et à ses performances possibles en génération selon le modèle. MLX et le cache de prompts peuvent modifier l’écart observé. Le coût compte aussi, avec un câble à ajouter pour les Spark. Comparez vos modèles, vos prompts et votre nombre d’utilisateurs : vous choisirez ainsi la configuration qui réduit réellement vos temps d’inférence et vos coûts.
FAQ
-
Quelle configuration génère le plus vite des tokens ?
Sur DeepSeek V4 Flash, les deux configurations atteignent environ 34 à 38 tokens par seconde. Le Mac peut être plus rapide en génération sur certains modèles, mais les résultats varient selon le modèle et le logiciel. -
Quel système traite le plus vite un prompt de 32 000 tokens ?
Les deux DGX Spark traitent ce contexte en environ 17 secondes. Le Mac Studio M5 Ultra demande environ 44 à 50 secondes dans les tests rapportés. -
Comment deux DGX Spark exécutent-ils un même modèle ?
Avec vLLM et le parallélisme tensoriel, le modèle est réparti entre les deux GPU. Ils échangent des résultats via une liaison RoCE/RDMA à chaque token. -
Le cache de prompts améliore-t-il les performances du Mac ?
Oui, pour les requêtes répétées, le cache de prompts réduit l’écart de traitement observé entre le Mac et le cluster DGX Spark. -
Quel est le coût comparé des deux configurations ?
La configuration Mac testée coûte environ 14 000 dollars. Les deux DGX Spark coûtent environ 10 000 dollars, auxquels il faut ajouter le câble RDMA.
A propos de l’auteur
Franck Scandolera est expert en data engineering et en automatisation IA. Il conçoit des systèmes d’inférence et des applications métier intelligentes en tenant compte des modèles, des performances et des contraintes d’exploitation.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.