
L’exécution complète de Ling 3.1 Flash exige une mémoire GPU hors de portée d’une carte grand public. La location donne accès à des configurations multi-GPU adaptées, mais ne résout pas l’indisponibilité des poids au moment de leur publication. Voici les contraintes à vérifier avant de lancer un test.
Qu’est-ce que Ling 3.1 Flash ?
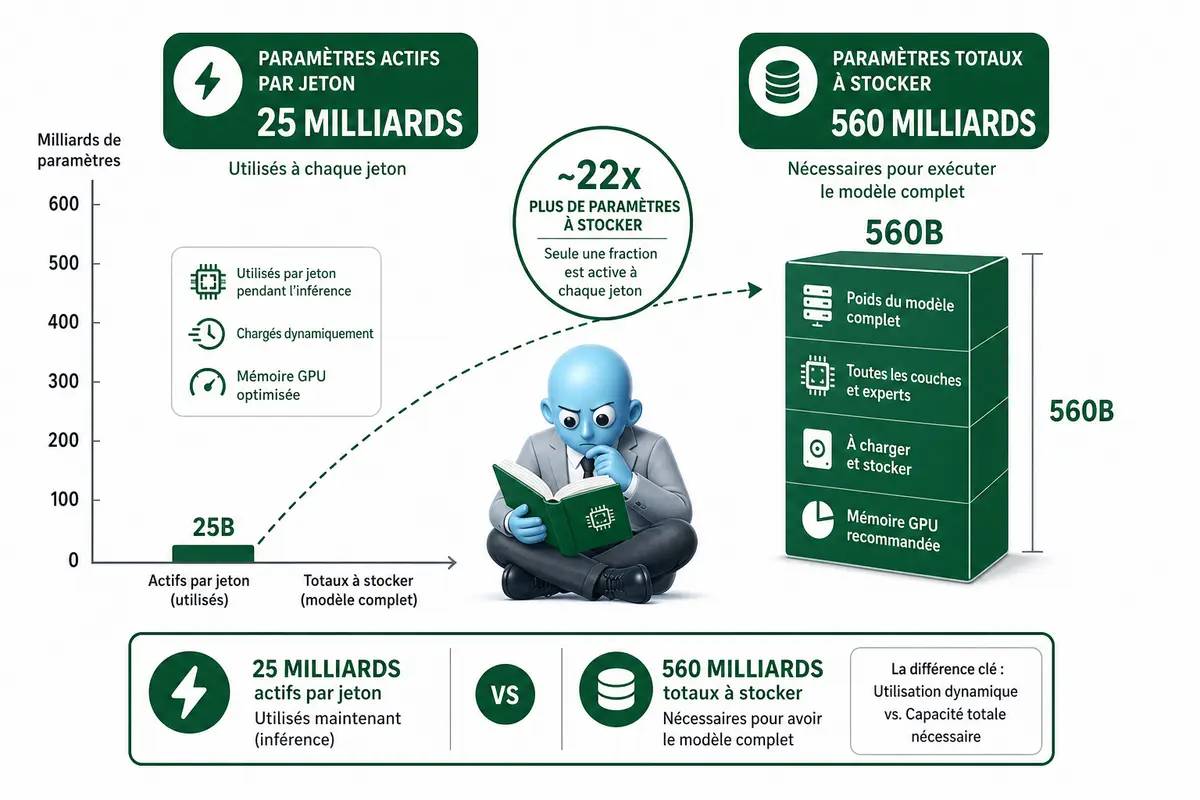
Ling 3.1 Flash est un modèle hybride de raisonnement développé par Ant Group. Il repose sur une architecture Mixture of Experts (MoE), c’est-à-dire que le modèle dispose de plusieurs experts, mais qu’un sous-ensemble seulement est activé pour traiter chaque jeton. Sa taille totale est d’environ 560 milliards de paramètres, dont quelque 25 milliards actifs par jeton. Ces deux chiffres ne décrivent pas la même chose : les 25 milliards ne sont pas la taille complète du modèle, mais la part mobilisée pour chaque jeton.
Ce modèle vise notamment le code et les tâches agentiques, où un système doit enchaîner des actions pour atteindre un objectif. Sa fenêtre de contexte peut atteindre un million de jetons, ce qui permet de traiter de très longues entrées. Cette capacité ne garantit pas, à elle seule, une meilleure qualité : les résultats sont solides sur certaines tâches pratiques et structurées, mais restent inégaux sur des tâches agentiques ouvertes.
Ling 3.1 Flash prend en charge plusieurs grandes langues. Les performances peuvent toutefois être plus limitées pour des langues moins dotées en données et en ressources. Ce point compte dès qu’un déploiement vise un public multilingue : la prise en charge d’une langue ne garantit pas un niveau de qualité équivalent d’une langue à l’autre.
Au moment de la publication, les poids du modèle ne sont pas ouverts, malgré une ouverture annoncée. Il faut donc distinguer les capacités présentées et l’accès effectif au modèle. Pour l’exécuter sur des GPU loués, cette disponibilité des poids est une contrainte centrale : sans fichiers accessibles, un déploiement autonome n’est pas possible.
Quel matériel faut-il pour le faire tourner ?
Les paramètres actifs ne suffisent pas à estimer la mémoire nécessaire. Ling 3.1 Flash compte environ 560 milliards de paramètres au total, et il faut distinguer le calcul effectué pour chaque jeton du stockage des poids du modèle.
Sur une architecture à experts, seuls certains paramètres peuvent être mobilisés pour traiter un jeton donné. Cela réduit le volume de calcul par jeton, mais ne signifie pas que les autres poids disparaissent : pour exécuter le modèle complet, l’ensemble des poids doit rester accessible, réparti entre les GPU ou via une autre forme de stockage. C’est la différence clé entre le coût de calcul et l’empreinte mémoire.
| Calcul par jeton | Dépend des paramètres activés pour produire le jeton. Il influe notamment sur le débit et les besoins de calcul. |
| Stockage du modèle | Dépend des poids à charger, donc de l’ensemble des paramètres, ainsi que de leur représentation numérique. |
| Mémoire d’exécution | S’ajoute aux poids : cache KV, activations et mémoire utilisée par le moteur d’inférence. |
L’exécution complète dépasse les capacités d’un GPU grand public. La quantification, qui représente les poids avec moins de bits, réduit leur empreinte mémoire, mais ne ramène pas le modèle à une configuration ordinaire : il faut encore mobiliser des centaines de gigaoctets de mémoire. Le cache KV peut aussi croître avec la longueur du contexte et le nombre de requêtes traitées en parallèle.
En pratique, je considère les configurations multi-GPU à forte mémoire comme l’option la plus réaliste. La mémoire doit être suffisante au total, et les GPU doivent pouvoir répartir les poids sans créer un goulot d’étranglement majeur. Le dimensionnement dépend ensuite du moteur d’inférence, du contexte visé et de la concurrence attendue. Je ne retiens pas de minimum universel sans données vérifiées sur ces paramètres.
À contrôler avant de louer : la mémoire GPU agrégée, la mémoire réellement disponible après chargement, l’interconnexion entre GPU, la prise en charge du modèle par le moteur et la marge nécessaire pour le cache KV et les requêtes simultanées.
Pourquoi louer des GPU pour ce modèle ?
Louer des GPU permet d’accéder à la mémoire et aux interconnexions nécessaires pour exécuter Ling 3.1 Flash, sans acheter plusieurs cartes coûteuses. C’est pertinent quand la configuration matérielle décrite dans le chapitre précédent dépasse ce que vous avez déjà à disposition.
Le choix est particulièrement adapté aux essais ponctuels : valider un déploiement, mesurer la compatibilité d’une configuration ou tester un traitement sans immobiliser du matériel. Il convient aussi aux usages intermittents, quand la charge ne justifie pas de maintenir plusieurs GPU (processeurs graphiques) disponibles en permanence.
Le coût dépend principalement du temps de calcul loué. Vous évitez ainsi l’investissement initial et la gestion d’un équipement rarement utilisé. En revanche, la location ne supprime pas les contraintes matérielles : la capacité mémoire et les interconnexions doivent toujours correspondre aux besoins du modèle. Louer une configuration insuffisante ne rendra pas l’exécution possible.
Il faut aussi séparer deux accès qui sont souvent confondus :
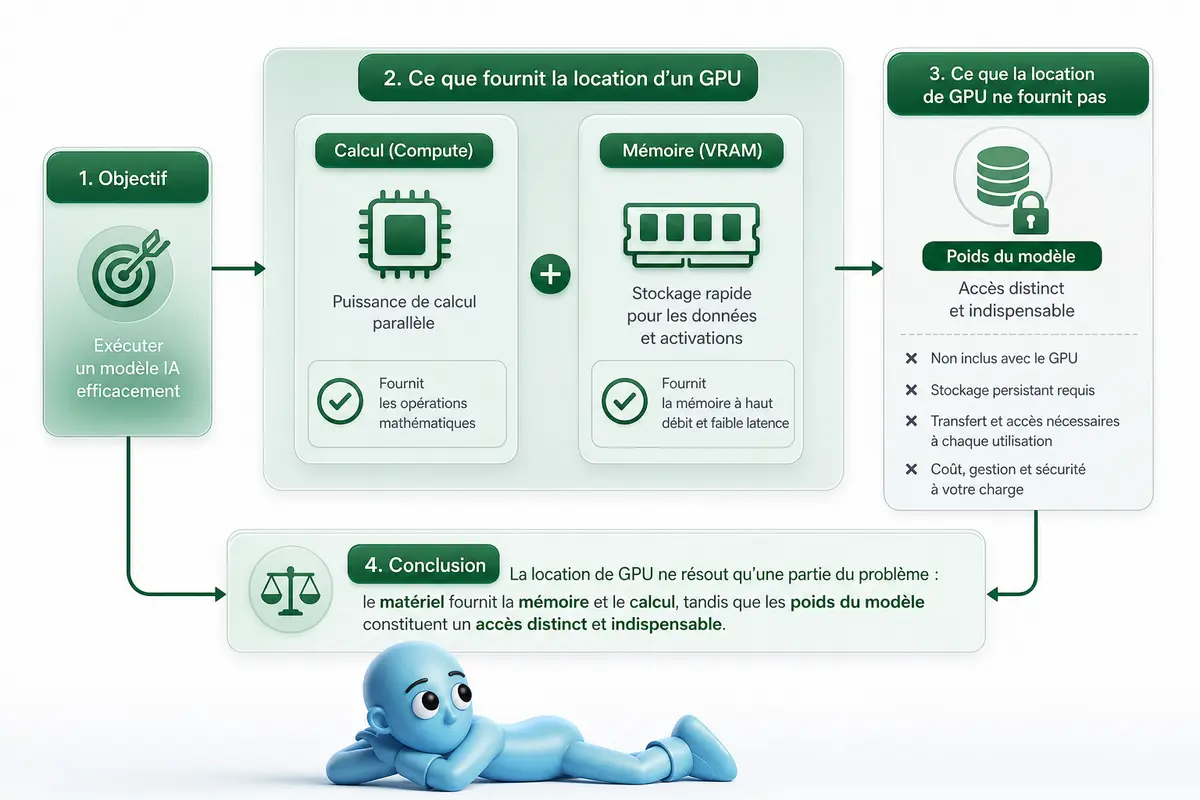
- L’accès au matériel : les GPU, leur mémoire et leur interconnexion.
- L’accès aux poids : les fichiers contenant les paramètres appris du modèle.
Disposer des GPU ne rend donc pas Ling 3.1 Flash exécutable si ses poids ne sont pas disponibles dans un format exploitable. Vérifiez leur accès et leur emplacement avant de réserver la capacité de calcul. J’ai déjà vu des essais bloqués non par le matériel, mais par l’absence des fichiers nécessaires au démarrage.
Les poids sont-ils disponibles pour un test local ?
Au moment de la publication, les poids de Ling 3.1 Flash ne sont pas encore ouverts, même si leur ouverture a été annoncée. Sans accès effectif aux poids, vous ne pouvez pas charger le modèle pour l’exécuter localement. Louer un GPU ne change rien à ce point : la machine fournit de la puissance de calcul, pas les paramètres du modèle ni les droits d’accès nécessaires.
La disponibilité des poids est donc un prérequis, pas un détail d’installation. Il faut aussi connaître les conditions d’accès et les caractéristiques attendues pour les charger correctement. Sans ces informations, impossible de confirmer qu’une configuration GPU donnée convient, d’estimer la mémoire nécessaire ou de préparer un environnement reproductible.
Avant de réserver une machine, je vérifierais ces éléments :
- Disponibilité effective : les poids sont-ils publiés et réellement accessibles, ou leur ouverture est-elle encore seulement annoncée ?
- Conditions d’accès : faut-il obtenir une autorisation, accepter des conditions d’utilisation ou disposer d’un compte spécifique ?
- Informations de chargement : la variante exacte du modèle, son architecture et les éléments associés nécessaires à son chargement sont-ils documentés ?
- Contraintes matérielles : les besoins en mémoire GPU et les matériels pris en charge sont-ils précisés ?
- Prérequis logiciels : les composants et versions nécessaires à l’exécution sont-ils explicitement indiqués ?
Je ne réserverais pas de GPU sur la seule base d’une annonce d’ouverture. Tant que les poids, les conditions d’accès et les informations techniques ne sont pas vérifiés, le risque est de payer une machine inutilisable pour ce test.
À ce stade, je ne peux pas fournir de tutoriel d’installation reproductible. Il manquerait des éléments vérifiés sur lesquels fonder les étapes de chargement et d’exécution. Dès que ces informations sont publiées, on pourra choisir une configuration adaptée et documenter le test sans supposer de prérequis.
Ling 3.1 Flash vaut-il le coût des essais ?
Ling 3.1 Flash vaut le coût d’un essai si vos tâches ressemblent à celles où il a déjà montré des résultats utiles. Les retours disponibles sont contrastés : ils donnent des pistes, pas une garantie de performance pour votre contexte.
Des exemples rapportés sont encourageants sur des tâches délimitées :
- Une optimisation SQL a abouti.
- Un SVG a été produit en une seule passe et jugé visuellement convaincant.
- Une note de consultation clinique structurée a été rédigée rapidement.
À l’inverse, des difficultés ont été observées sur des tâches agentiques ouvertes, où le modèle doit enchaîner des actions et gérer une situation moins cadrée. Ces éléments ne permettent pas de conclure que Ling 3.1 Flash échouera sur toutes les tâches de ce type, ni de généraliser les réussites citées à d’autres cas.
Pour un essai sur GPU loué, je traiterais le test comme une évaluation ciblée, pas comme une démonstration générale. Le protocole doit être défini avant de lancer les instances :
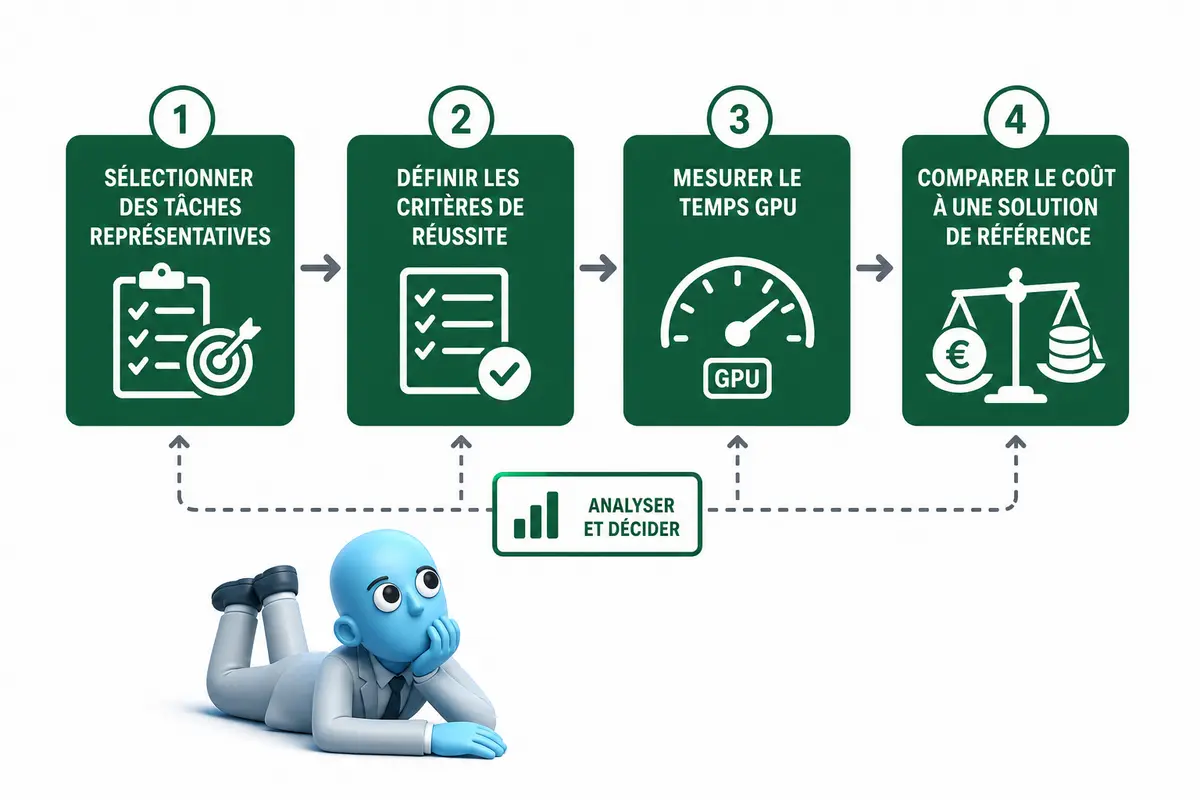
- Choisir quelques tâches représentatives de votre usage réel, avec des entrées proches de celles de production.
- Fixer à l’avance les critères de réussite : exactitude, conformité au format, qualité visuelle ou taux de correction humaine, selon la tâche.
- Chronométrer l’exécution et relever le temps de GPU facturé, pas seulement le temps de réponse apparent.
- Comparer le coût total à celui d’une solution de référence, en incluant les relances et les corrections nécessaires.
Un test court peut suffire à repérer les cas où le modèle est utile et ceux où il demande trop de supervision. Je ne déduirais pas d’une optimisation SQL réussie qu’il sera fiable sur des requêtes différentes, ni d’un SVG convaincant qu’il produira systématiquement le résultat attendu. La décision dépend de vos tâches, de vos critères et du coût réel du temps de calcul.
Est-ce le bon moment pour lancer votre essai ?
Ling 3.1 Flash combine une architecture MoE de grande taille, une fenêtre de contexte pouvant atteindre un million de jetons et des résultats intéressants sur certaines tâches structurées. Mais ses 25 milliards de paramètres actifs ne réduisent pas le besoin de stocker l’ensemble des poids : l’exécution demande une mémoire GPU très élevée, généralement accessible via plusieurs GPU loués. Surtout, au moment de la publication, les poids ne sont pas encore ouverts. Avant de réserver une machine, vérifiez leur disponibilité et évaluez le modèle sur vos propres tâches. Vous éviterez une dépense prématurée et saurez si ses capacités justifient le coût de l’essai.
FAQ
-
Combien de paramètres Ling 3.1 Flash utilise-t-il par jeton ?
Environ 25 milliards de paramètres sont actifs par jeton, sur un modèle d’environ 560 milliards de paramètres au total. -
Pourquoi 25 milliards de paramètres actifs ne suffisent-ils pas à estimer la mémoire GPU ?
Parce que le modèle doit aussi stocker les poids des quelque 560 milliards de paramètres. Le nombre de paramètres actifs renseigne sur le calcul par jeton, pas sur la taille totale des poids à charger. -
Un GPU grand public peut-il exécuter le modèle complet ?
Non. L’exécution complète dépasse les capacités d’un GPU grand public. Même quantifié, le modèle demande des centaines de gigaoctets de mémoire ; une configuration multi-GPU à forte mémoire est plus réaliste. -
La location de GPU suffit-elle pour lancer un test ?
Non. Elle donne accès au matériel nécessaire, mais il faut aussi disposer des poids et des informations permettant de les charger. Au moment de la publication, les poids ne sont pas encore ouverts, malgré une ouverture annoncée. -
Sur quelles tâches Ling 3.1 Flash a-t-il montré des résultats intéressants ?
Les résultats rapportés incluent une optimisation SQL réussie, un SVG jugé visuellement convaincant après une seule passe et une note de consultation clinique structurée rédigée rapidement. Les performances sont plus inégales sur les tâches agentiques ouvertes.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en data, IA, tracking server-side, Analytics Engineering et automatisation no/low-code. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des entreprises comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise à cadrer ses projets data et IA : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.