
IQuest-Q1 affiche des résultats sur plusieurs benchmarks de codage agentique, mais ils sont publiés par IQuest et ne sont pas encore confirmés par une évaluation indépendante mentionnée ici. Voici ce que son architecture, ses tests et ses limites permettent réellement de conclure.
Qu’est-ce qu’IQuest-Q1 ?
IQuest-Q1 est un modèle open-weight à mélange d’experts conçu pour le codage agentique, le raisonnement et l’usage d’outils en plusieurs étapes. Ses caractéristiques décrivent une architecture ambitieuse, mais ne suffisent pas à établir son niveau de performance.
Open-weight signifie que les poids du modèle sont accessibles. Ce terme ne garantit pas, à lui seul, que tous les éléments du projet — comme les données d’entraînement ou le code complet — soient ouverts. IQuest-Q1 est un modèle textuel : il traite du texte, et non directement des images ou d’autres types de médias.
Le modèle compte environ 320 milliards de paramètres au total, dont 15 milliards sont activés pour chaque jeton traité. Il utilise une architecture à mélange d’experts, ou MoE : plusieurs sous-réseaux spécialisés sont disponibles, mais seuls certains sont sollicités pour chaque jeton. Ces chiffres décrivent la structure du modèle. Ils ne permettent pas, à eux seuls, de conclure à sa vitesse, à sa qualité ou aux ressources nécessaires pour le faire fonctionner.
Sa fenêtre de contexte maximale est de 524 288 jetons. Un jeton est une unité de texte utilisée par le modèle pour traiter une entrée ou produire une réponse ; ce n’est pas toujours un mot entier. Une grande fenêtre permet de fournir beaucoup de texte dans un même échange, sans garantir que le modèle en exploite chaque élément correctement.
IQuest-Q1 reste un modèle précoce. Pour comprendre ce qu’il sait réellement faire, il faut donc regarder ses évaluations avec attention : les tâches choisies, les conditions de test et les comparaisons comptent autant que les scores publiés. C’est là que les benchmarks permettent de distinguer les capacités mesurées des simples promesses de conception.
Comment IQuest-Q1 a-t-il été évalué ?
Les évaluations d’IQuest-Q1 reposent sur des environnements d’agents de codage, pas seulement sur des invites isolées. Le modèle doit y comprendre une tâche, explorer un dépôt de code, utiliser des outils et produire une solution. Les scores mesurent donc à la fois le modèle et sa capacité à travailler dans un environnement donné.
Claude Code sert de principal harnais d’évaluation. Un harnais, c’est l’ensemble qui relie le modèle aux outils, au dépôt et aux règles d’exécution. Certaines comparaisons utilisent mini-SWE-agent, un agent plus léger conçu pour résoudre des problèmes logiciels. Pour un benchmark particulier, l’évaluation s’appuie sur une version plus récente de Claude Code.
Ces différences comptent. Une version du harnais peut modifier les outils disponibles, la façon dont les consignes sont transmises ou le déroulement d’une tâche. Les paramètres d’échantillonnage — qui déterminent notamment comment le modèle génère ses réponses — peuvent aussi influer sur les résultats. Je ne peux donc pas lire un score comme une propriété indépendante du protocole, ni supposer qu’il sera reproduit à l’identique avec un autre harnais ou d’autres paramètres.
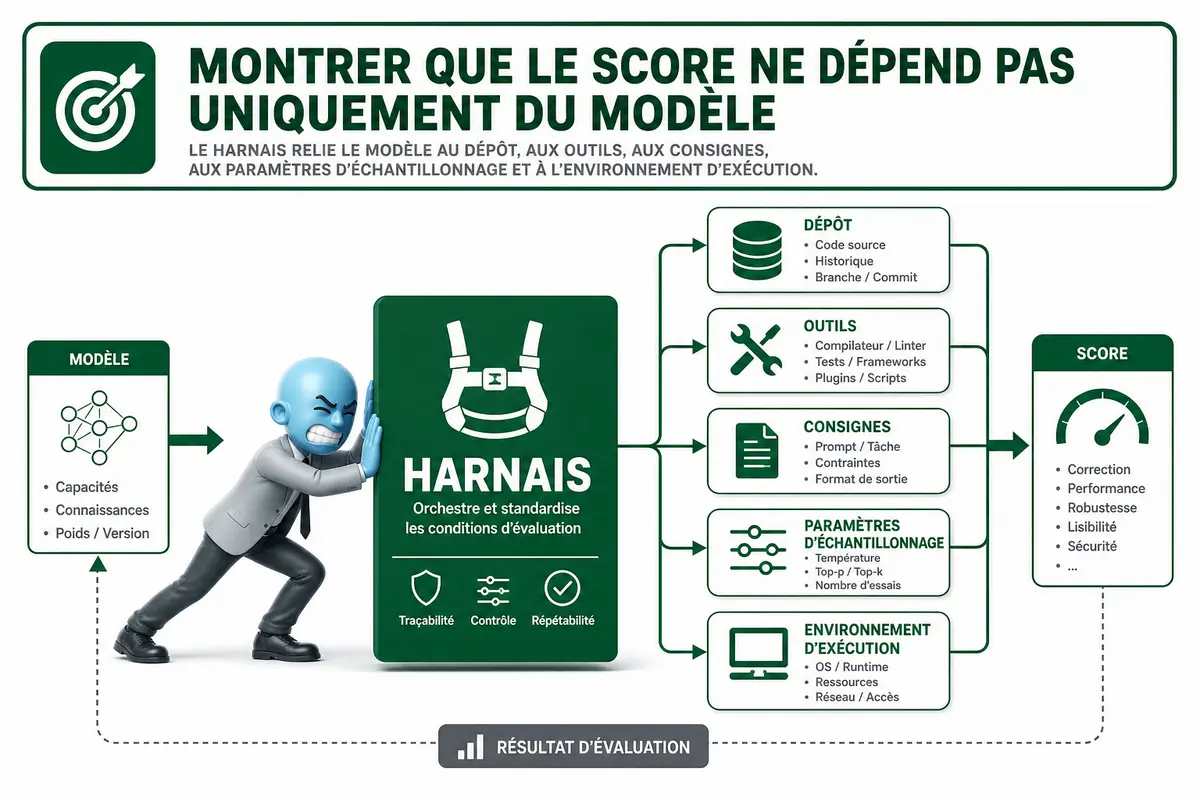
Pour comparer les résultats, il faut regarder dans quelles conditions chaque modèle a été évalué : quel agent l’encadre, quel environnement il utilise et si les conditions sont les mêmes d’un système à l’autre. Sans ces précisions, un écart de score peut refléter autant le dispositif d’évaluation que le modèle lui-même.
C’est dans ce cadre qu’il faut aborder les familles de tests rapportées : les évaluations de résolution de problèmes dans des dépôts de code, les tâches réalisées dans un environnement de terminal et les comparaisons menées avec différents harnais. Elles ne mesurent pas toutes exactement la même capacité, et leurs scores ne sont pas directement interchangeables.
Quels benchmarks IQuest-Q1 rapporte-t-il ?
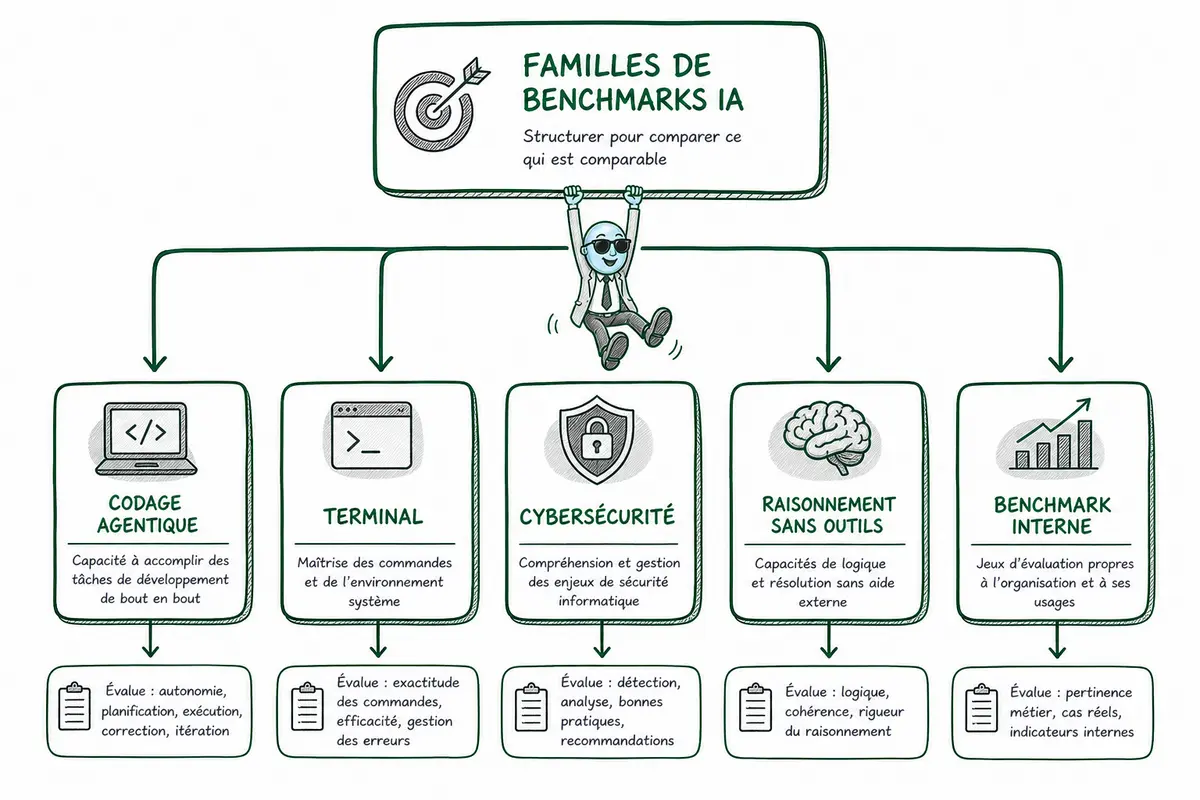
Les résultats publiés couvrent plusieurs tâches de codage, de terminal, de cybersécurité et de raisonnement. Ils cherchent à évaluer IQuest-Q1 dans des situations variées, pas seulement sur des exercices de programmation classiques.
Le codage agentique concerne des tâches où le modèle doit agir pour produire une solution, plutôt que simplement compléter ou expliquer du code. Terminal-Bench 2.1 évalue des tâches réalisées en ligne de commande. CyberGym porte sur des scénarios de cybersécurité. Humanity’s Last Exam teste le raisonnement sans accès aux outils. Enfin, IQuest-CLIBench est le benchmark interne d’IQuest consacré à l’expérience en ligne de commande.
IQuest compare aussi ses résultats à ceux de DeepSeek-V4-Flash et de DeepSeek-V4-Pro. Ces comparaisons donnent un point de repère, mais les informations disponibles ne permettent pas de présenter ici des scores ou des classements fiables. Je n’en invente donc pas.
Un point compte pour interpréter ces chiffres : les évaluations mentionnées sont rapportées par IQuest. Aucun résultat indépendant publié sur Hugging Face n’est signalé dans les informations disponibles. Ce n’est pas la même chose qu’une validation externe, où une autre équipe reproduit les tests avec les mêmes consignes, outils et conditions.
Ces benchmarks indiquent donc les domaines qu’IQuest a choisi de tester et les modèles auxquels il se compare. Ils ne suffisent pas, à eux seuls, à établir les capacités générales de Q1. La suite dépend des protocoles utilisés, des tâches sélectionnées et de la possibilité de reproduire les évaluations.
Que faut-il retenir des résultats et des limites ?
Ces benchmarks donnent des indications sur les capacités testées, mais ne suffisent pas à établir une validation indépendante des performances d’IQuest-Q1. Ils montrent des résultats dans des conditions données, pas ce que le modèle fera systématiquement sur vos dépôts, vos outils et vos contraintes de production.
Il faut distinguer les résultats rapportés par IQuest des conclusions qu’on peut en tirer. Les scores publiés décrivent la performance du modèle sur les tâches et les protocoles évalués. Ils permettent de repérer des points forts ou des écarts entre modèles, mais ne prouvent pas à eux seuls une supériorité générale. Pour cela, il faudrait notamment pouvoir reproduire les tests, examiner les tâches utilisées et comparer les modèles dans des conditions identiques.
IQuest-Q1 est présenté comme un modèle encore précoce. Des difficultés peuvent apparaître lors de longues sessions de débogage en CLI, c’est-à-dire dans une interface en ligne de commande où l’on interagit avec des outils et des fichiers. Une session longue exige de conserver le contexte, de suivre les changements et de vérifier que les corrections n’introduisent pas de régressions. Un bon score sur une tâche isolée ne garantit pas cette continuité.
Le modèle nécessite aussi des ressources GPU importantes. Le coût matériel, le temps d’exécution et les contraintes de déploiement comptent donc autant que les scores. Les informations disponibles ne donnent ni durée précise pour les limites de temps évoquées ni résultats détaillés sur ce point. Je ne peux pas en déduire un seuil fiable.
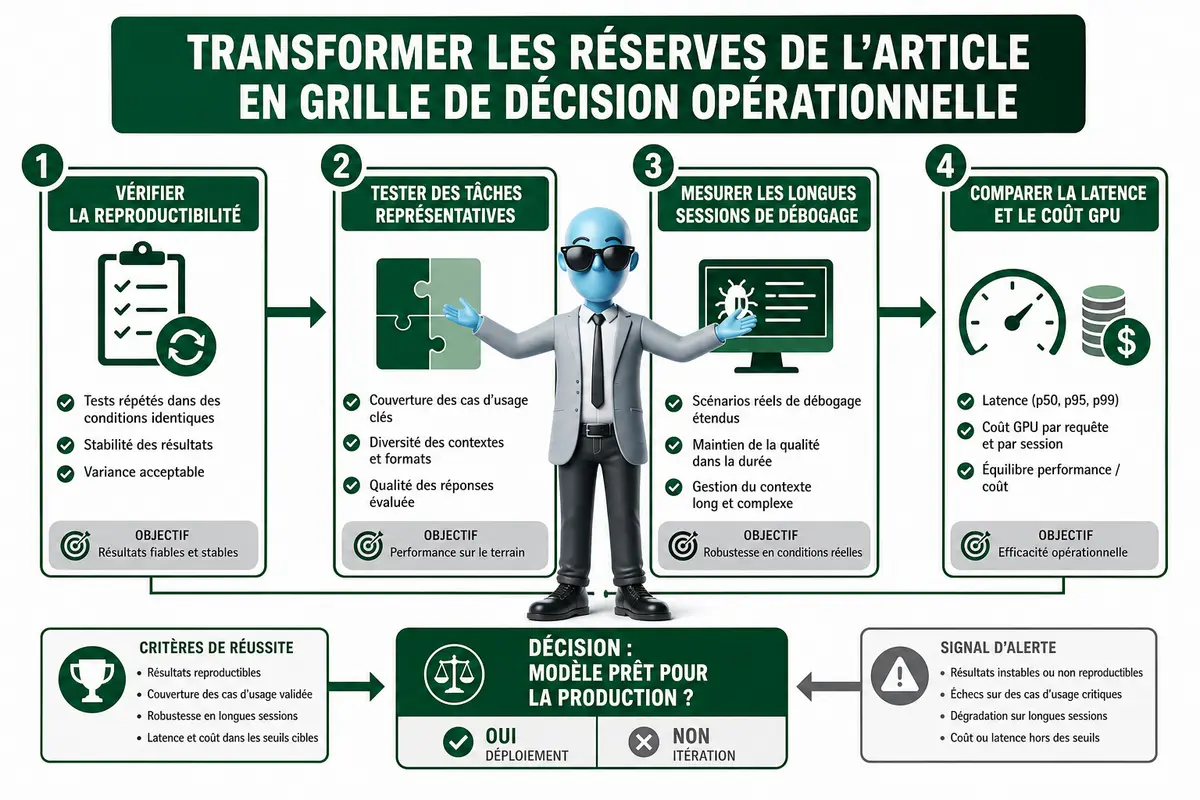
Pour évaluer le modèle, je regarderais les tâches réellement représentatives de votre usage, la reproductibilité des résultats, la qualité des corrections sur plusieurs étapes, la latence et le coût GPU. Un test interne sur vos propres cas d’usage reste plus utile qu’un classement pris isolément.
| Élément | Ce qu’on peut retenir | Réserve |
| Benchmarks publiés | Des indications sur les capacités mesurées. | Pas une validation indépendante ni une garantie en production. |
| Débogage en CLI | Le modèle peut aider sur des tâches de code. | Les longues sessions peuvent révéler des difficultés de suivi et de cohérence. |
| Ressources et temps | Les besoins GPU sont importants. | Aucune durée précise ni aucun résultat détaillé n’est établi pour les limites de temps. |
Que pouvez-vous conclure avant de le tester ?
IQuest-Q1 est un modèle open-weight ambitieux, orienté vers le codage agentique, avec une architecture à mélange d’experts et un contexte annoncé de 524 288 jetons. Ses évaluations couvrent plusieurs familles de benchmarks, mais elles sont rapportées par IQuest et dépendent notamment du harnais et des paramètres utilisés. Il faut donc éviter de lire les résultats comme une validation indépendante ou comme une garantie de performance dans votre environnement. Le modèle reste précoce, peut peiner sur de longues sessions de débogage en CLI et demande des ressources GPU importantes. Vérifiez les protocoles, les besoins d’exécution et vos propres cas d’usage : vous saurez ainsi si ses capacités répondent réellement à votre besoin.
FAQ
-
Qu’est-ce qu’IQuest-Q1 ?
C’est un modèle open-weight à mélange d’experts conçu pour le codage agentique, le raisonnement et l’utilisation d’outils en plusieurs étapes. Il totalise environ 320 milliards de paramètres, dont 15 milliards sont activés par jeton. -
Les benchmarks d’IQuest-Q1 ont-ils été validés indépendamment ?
Les résultats présentés sont ceux publiés par IQuest. Les informations disponibles ne signalent pas de résultats indépendants publiés sur Hugging Face. -
Quels tests sont utilisés pour évaluer le modèle ?
La suite comprend du codage agentique, Terminal-Bench 2.1, CyberGym, Humanity’s Last Exam sans accès aux outils et IQuest-CLIBench, consacré à l’expérience en ligne de commande. -
Pourquoi le harnais d’évaluation compte-t-il ?
Les résultats dépendent notamment du harnais utilisé, de sa version et des paramètres d’échantillonnage. Ces choix peuvent donc influencer les comparaisons et la reproduction des tests. -
Quelles sont les limites pratiques d’IQuest-Q1 ?
Le modèle est encore précoce, peut rencontrer des difficultés lors de longues sessions de débogage en CLI et demande des ressources GPU importantes. Son contexte maximal annoncé est de 524 288 jetons.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en data, IA et automatisation low-code. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne les entreprises sur leurs projets d’IA et de data, avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise à évaluer ses usages de l’IA : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.