
Les projets Jev sur GitHub illustrent comment transformer un contexte et des questions typées en décisions probabilisées. Jev peut servir au routage, au classement, au filtrage et au suivi. Voici comment comprendre le modèle et évaluer ses usages sans confondre le moteur de décision avec les actions de l’application.
Qu’est-ce que Jev ?
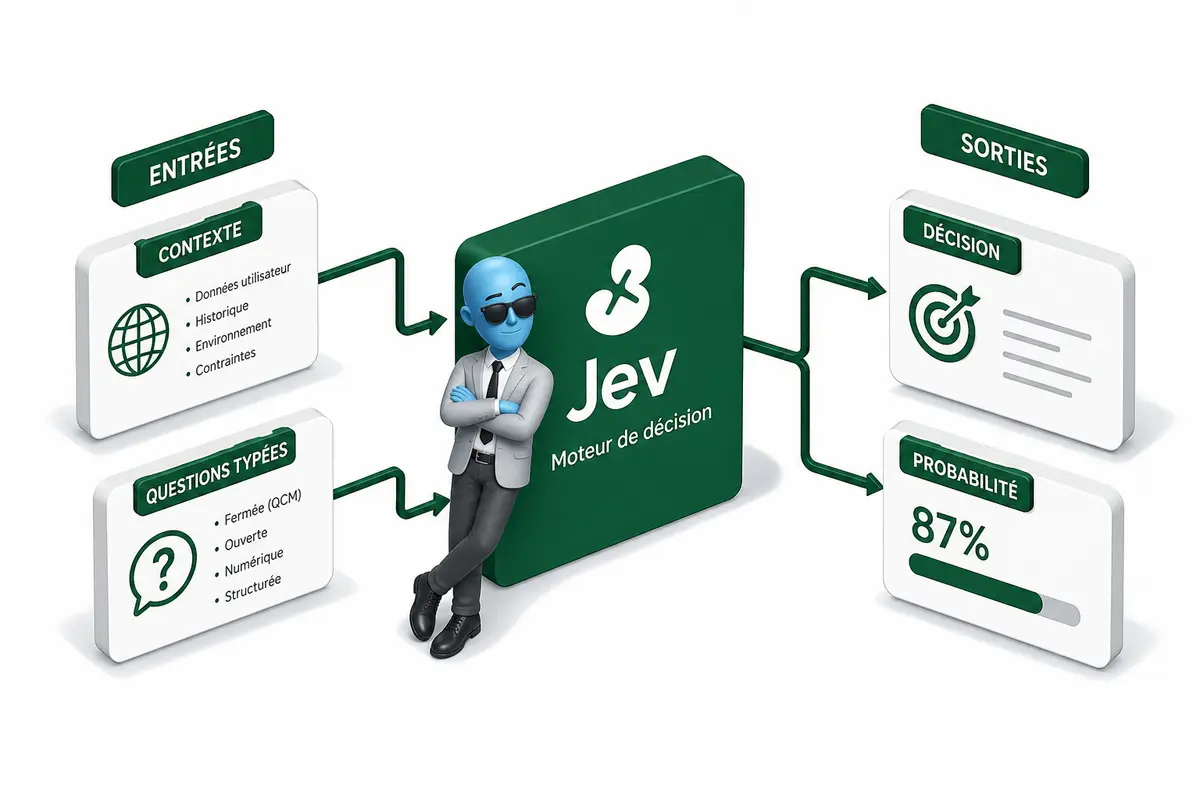
Jev est un modèle de décision de TypeSafe qui transforme un contexte et des questions à réponses typées en décisions accompagnées de probabilités. Autrement dit, il met en relation des informations fournies, des questions dont les réponses sont encadrées par des types, et une décision produite à partir de cet ensemble.
Le contexte, c’est la matière fournie au modèle. Il sert à situer la décision. Il ne s’agit pas de la décision elle-même, mais des informations qui l’accompagnent et qui permettent de poser les questions pertinentes.
Les questions à réponses typées définissent ce qui est demandé et la forme attendue pour les réponses. « Typées » signifie ici que les réponses ne sont pas laissées sans cadre : elles sont associées à des types. Cette distinction aide à comprendre le rôle des questions dans le modèle. Elles ne sont ni le contexte, ni la décision finale.
La décision est le résultat produit. Jev transforme donc ces éléments en une décision, et pas simplement en une suite de réponses aux questions. Les probabilités accompagnent cette décision : elles font partie du résultat présenté, plutôt que d’être confondues avec le contexte ou les questions.
On peut résumer Jev en trois éléments distincts : un contexte fourni, des questions avec des réponses typées, puis une décision accompagnée de probabilités. Cette formulation décrit son rôle sans lui attribuer d’autres capacités. Elle permet aussi de distinguer clairement les données d’entrée du résultat : le contexte et les questions sont fournis, tandis que la décision et ses probabilités constituent la sortie.
Comment Jev produit-il une décision ?
Jev s’appuie sur un contexte et des questions à réponses typées pour produire des décisions assorties de probabilités. Le contexte fournit les éléments à prendre en compte. Les questions définissent ce que Jev doit évaluer et le type de réponse attendu, par exemple un texte, un nombre ou un choix parmi plusieurs options.
Ce format rend les échanges plus explicites qu’une consigne entièrement libre. Une question typée indique la forme attendue de la réponse ; elle peut donc faciliter son exploitation par un autre outil ou dans un flux automatisé. Elle ne prouve pas, à elle seule, que la réponse est exacte, ni que toutes les valeurs possibles sont correctement vérifiées.
La décision produite est associée à une probabilité. On peut y voir une indication chiffrée liée à cette décision, utile pour comparer des résultats ou décider lesquels méritent une vérification humaine. Mais une probabilité n’est pas une garantie. Sans information supplémentaire, je ne peux pas affirmer qu’elle est calibrée, qu’elle mesure une certitude au sens statistique ou qu’un seuil donné suffit à déclencher une action sans contrôle.
Comme vu dans le chapitre précédent, le modèle joue un rôle central dans le traitement du contexte et des questions. Jev s’appuie sur ce modèle pour formuler ses décisions ; les informations disponibles ne permettent pas de décrire plus précisément les opérations internes, ni d’affirmer qu’il suit un mécanisme particulier d’entraînement.
À retenir :
- Le contexte et les questions typées structurent les informations soumises au modèle.
- Les probabilités accompagnent les décisions, sans garantir leur exactitude.
- Le format des réponses peut faciliter leur intégration dans un processus, mais ne remplace pas la validation.
À quoi peut servir Jev ?
Jev peut servir au routage, au classement, au filtrage et au suivi. Dans le fonctionnement décrit précédemment, Jev produit une décision à partir des informations qui lui sont présentées. Cette décision ne réalise pas, à elle seule, une action dans l’application. C’est l’application qui définit les actions possibles et qui les exécute en fonction du résultat reçu.
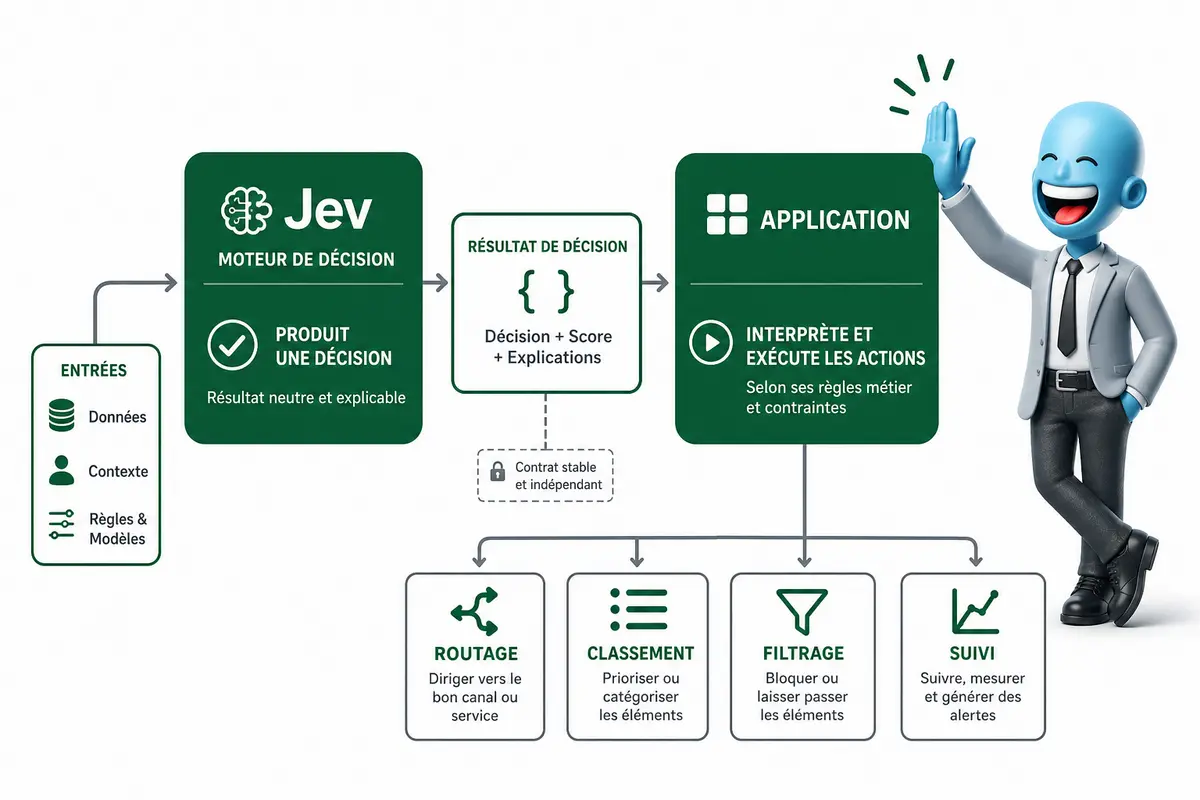
- Routage. Jev peut déterminer vers quelle destination orienter un élément. Il fournit le résultat de cette décision, tandis que l’application se charge de l’acheminer selon les règles qu’elle définit.
- Classement. Jev peut attribuer une catégorie ou une classe à un élément. L’application peut ensuite exploiter cette catégorie pour appliquer le comportement prévu. Jev classe ; il ne choisit pas seul ce que l’application fera de ce classement.
- Filtrage. Jev peut décider si un élément correspond à un critère donné ou s’il doit être retenu. L’application utilise cette décision pour laisser passer, écarter ou traiter l’élément, selon les actions disponibles.
- Suivi. Jev peut contribuer à déterminer un état ou une étape à partir des informations analysées. L’application peut ensuite enregistrer ou faire évoluer cet état, si son fonctionnement le prévoit.
La distinction est importante : Jev fournit une décision, pas une automatisation complète. Les actions concrètes dépendent de l’application qui l’intègre. C’est le même principe que dans les chapitres précédents : Jev intervient dans la production du résultat, puis l’application interprète ce résultat et exécute les actions qu’elle a définies. Cette séparation permet de comprendre ce que fait réellement Jev, sans lui attribuer des capacités qui relèvent de l’application.
Comment examiner les projets Jev sur GitHub ?
Les projets présentés sont des exemples d’usages de Jev, mais les informations disponibles ne permettent ni d’identifier précisément les dépôts GitHub ni de décrire leurs implémentations. L’article annonce dix dépôts : cinq projets sont décrits, le sixième est seulement amorcé et les autres sections ne sont pas disponibles.
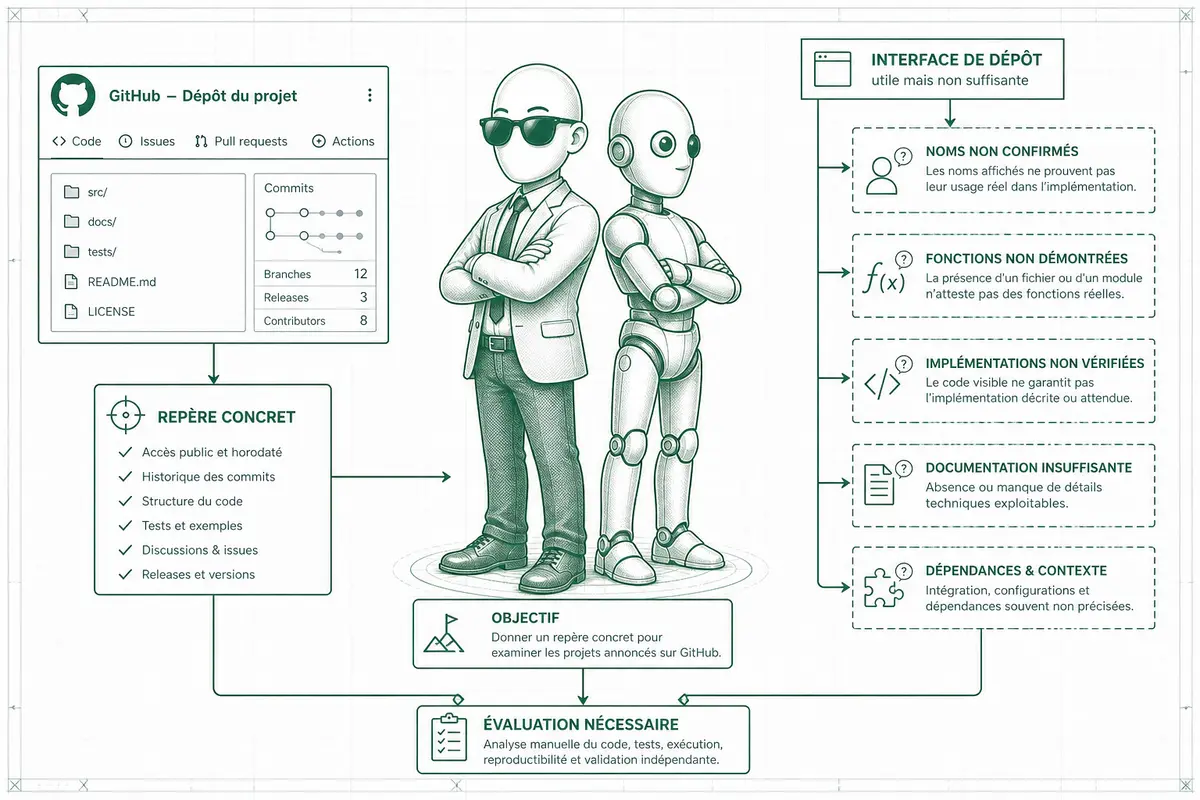
Les exemples sont censés illustrer des usages comme le routage, le classement, le filtrage et le suivi. Ces termes désignent des objectifs généraux : orienter des éléments, les organiser, sélectionner ceux qui répondent à certains critères ou suivre leur évolution. Ils ne permettent pas, à eux seuls, de savoir quelles actions chaque application définit, ni comment elle les réalise.
Cette distinction compte quand vous explorez un dépôt. Une catégorie d’usage ne décrit pas une fonctionnalité précise. Le routage, par exemple, peut recouvrir des comportements différents selon l’application ; sans documentation consultable ou code identifiable, je ne peux pas attribuer une action concrète à un projet Jev. Mieux vaut donc traiter ces exemples comme des pistes de lecture, pas comme une description technique vérifiée.
Dans ce cas, le plus fiable est de s’en tenir aux éléments explicitement disponibles et de laisser les zones inconnues ouvertes. Je ne peux pas confirmer les noms des dépôts, leurs liens, leurs fonctions ni leurs choix d’implémentation.
| Nombre de dépôts annoncé | Dix |
| Projets décrits | Cinq |
| Sixième projet | Seulement amorcé |
| Autres sections | Non disponibles |
| Usages évoqués | Routage, classement, filtrage et suivi |
| Noms, liens et implémentations des dépôts | Non identifiables avec les informations disponibles |
Que retenir avant d’explorer Jev ?
Jev est un modèle de décision de TypeSafe : il reçoit un contexte et des questions à réponses typées, puis produit des décisions accompagnées de probabilités. Ses usages possibles couvrent le routage, le classement, le filtrage et le suivi. L’application garde un rôle distinct : elle définit et exécute les actions possibles. La liste annoncée comprend dix dépôts, mais les informations disponibles ne décrivent que cinq projets et amorcent le sixième. Mieux vaut donc distinguer les usages établis des détails de dépôt qui ne sont pas documentés. Vous repartez avec un cadre clair pour comprendre Jev et évaluer ses exemples sans vous fier à des éléments non vérifiés.
FAQ
-
Qu’est-ce que Jev ?
Jev est un modèle de décision de TypeSafe. Il transforme un contexte et des questions à réponses typées en décisions accompagnées de probabilités. -
Quels usages Jev peut-il couvrir ?
Jev peut servir au routage, au classement, au filtrage et au suivi. -
Jev exécute-t-il lui-même les actions ?
Non. Le modèle produit une décision; l’application définit et exécute les actions possibles. -
Combien de dépôts GitHub sont annoncés ?
Dix dépôts sont annoncés. Les informations disponibles décrivent cinq projets et commencent à présenter le sixième. -
Peut-on connaître les noms et détails des dix projets ?
Non, les informations disponibles ne donnent pas les noms ni les détails complets des dépôts. Il vaut mieux ne pas les supposer.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en data, IA, automatisation No/Low Code, Analytics Engineering et tracking avancé. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des entreprises comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.